Was ist OCR? Optische Zeichenerkennung einfach erklärt
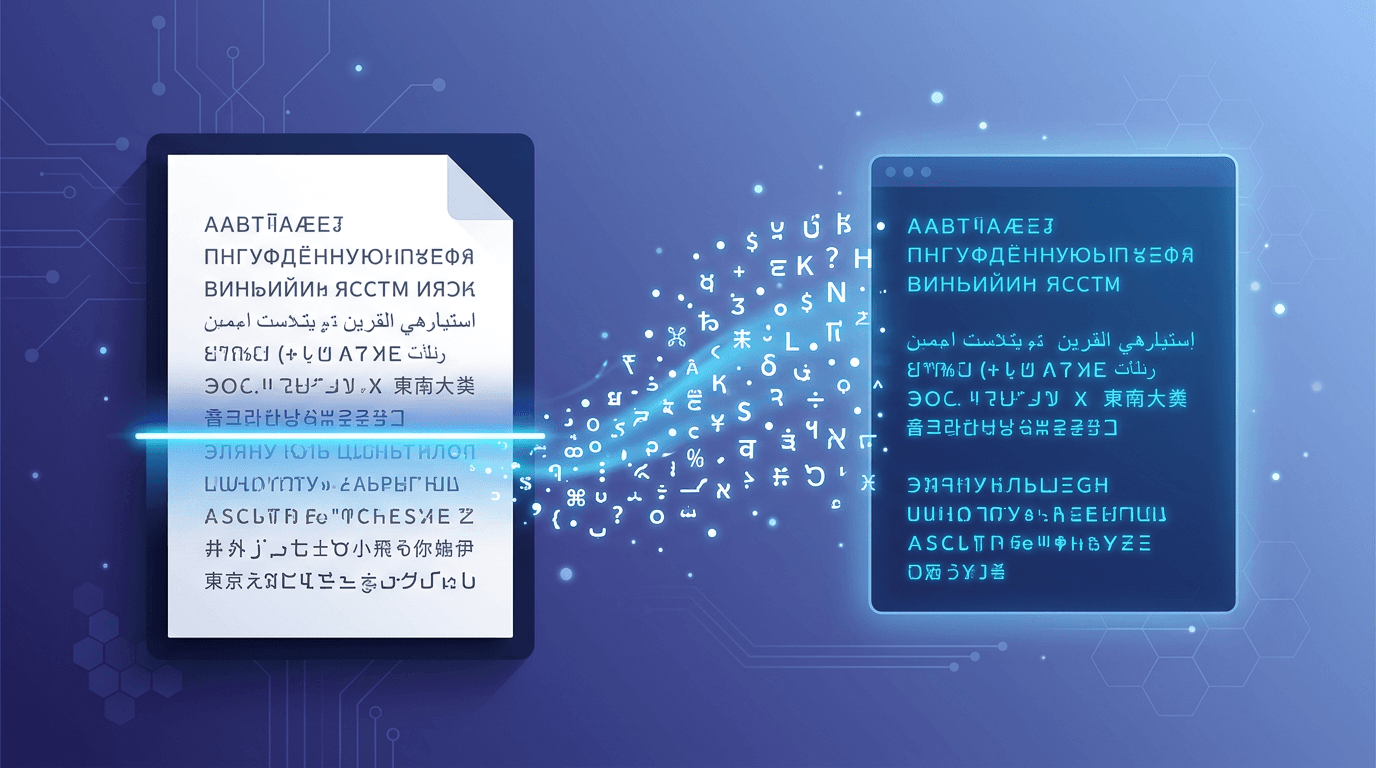
OCR steht für Optical Character Recognition, auf Deutsch „optische Zeichenerkennung“. Diese Technologie wandelt Bilder mit Text in maschinenlesbaren digitalen Text um. Dieser Ratgeber erklärt, wie OCR funktioniert und warum sie in unserer digitalen Welt unverzichtbar geworden ist.
Die folgenden Abschnitte erläutern OCR-Technologie im Allgemeinen. Funktionen wie die Rekonstruktion des Layouts, Übersetzung, automatische Spracherkennung und Modelle für Handschrift unterscheiden sich je nach Produkt. Das Tool „Bild in Text“ auf dieser Website extrahiert reinen Text aus einem einzelnen Bild mit einer manuell ausgewählten Sprache. Die genannten weitergehenden Funktionen bietet es nicht.
Was ist OCR?
OCR (optische Zeichenerkennung) ist eine Technologie mit folgenden Aufgaben:
- Text erkennen in Bildern, gescannten Dokumenten und Fotos
- Sichtbaren Text umwandeln in ein digitales, bearbeitbares Format
- Die Suche ermöglichen in zuvor nicht durchsuchbaren Bildern
- Die Dateneingabe automatisieren aus Papierdokumenten
Wie funktioniert OCR?
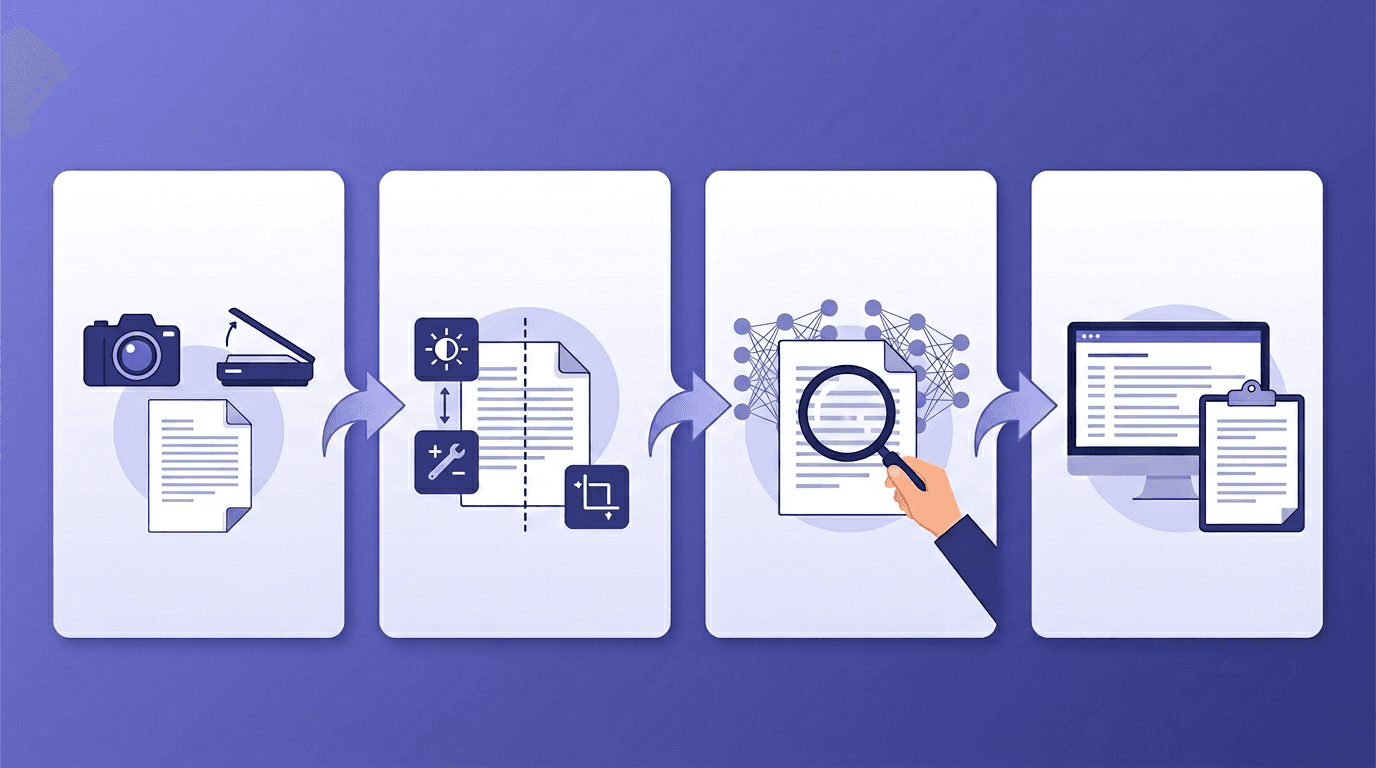
Schritt 1: Bilderfassung
Der Vorgang beginnt mit dem Erfassen eines Bildes:
- Einscannen von Papierdokumenten
- Fotografieren mit einer Kamera
- Erstellen von Screenshots
- Importieren vorhandener Bilder
Schritt 2: Bildvorverarbeitung
Das Bild wird für die Analyse vorbereitet:
- Binarisierung - Umwandlung in Schwarz-Weiß
- Rauschunterdrückung - Entfernen von Flecken und Artefakten
- Schräglagenkorrektur - Begradigen schiefen Textes
- Layoutanalyse - Erkennen von Textbereichen
Schritt 3: Zeichenerkennung
Algorithmen erkennen den Text:
- Musterabgleich - Vergleich mit bekannten Zeichenformen
- Merkmalserkennung - Erkennen charakteristischer Eigenschaften
- Maschinelles Lernen - Neuronale Netze, die anhand von Millionen Beispielen trainiert wurden
- Kontextanalyse - Nutzung sprachlicher Regeln zur Verbesserung der Genauigkeit
Schritt 4: Nachverarbeitung
Die Ergebnisse werden verbessert:
- Rechtschreibprüfung - Korrektur offensichtlicher Fehler
- Formatierungserhalt - Bewahren der Struktur
- Konfidenzbewertung - Angabe der Sicherheit des Erkennungsergebnisses
Arten der OCR
Standard-OCR
- Erkennt gedruckten Text in Standardschriftarten
- Funktioniert mit sauberen, hochwertigen Bildern
- Erzielt die höchste Genauigkeit bei einfachen Dokumenten
Intelligente Zeichenerkennung (ICR)
- Verarbeitet handschriftlichen Text
- Nutzt maschinelles Lernen zur Anpassung
- Verbessert sich durch Training
Intelligente Worterkennung (IWR)
- Erkennt vollständige Wörter
- Eignet sich besser für verbundene Schreibschrift
- Berücksichtigt den Kontext bei der Verarbeitung
Optische Markierungserkennung (OMR)
- Erkennt Markierungen und Kontrollkästchen
- Wird für Umfragen und Tests eingesetzt
- Unterscheidet binär zwischen markiert und nicht markiert
Einflussfaktoren auf die OCR-Genauigkeit
| Faktor | Einfluss auf die Genauigkeit |
|---|---|
| Bildqualität | Hoch |
| Schriftart | Mittel bis hoch |
| Textkontrast | Hoch |
| Dokumentzustand | Mittel |
| Sprachliche Komplexität | Mittel |
| Handschrift oder Druckschrift | Hoch |
Häufige OCR-Anwendungen
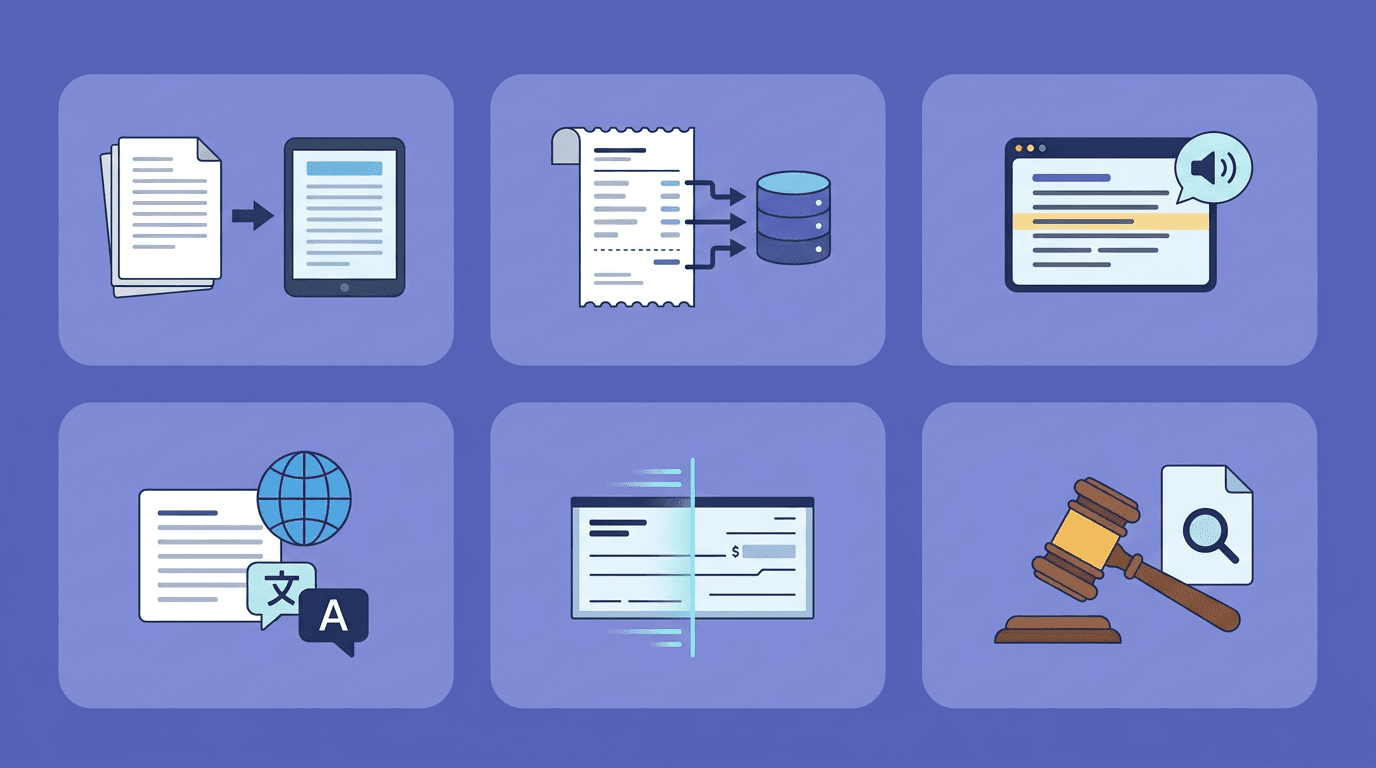
Dokumentendigitalisierung
Papierarchive in durchsuchbare digitale Dateien umwandeln.
Automatisierte Dateneingabe
Informationen aus Formularen, Rechnungen und Belegen extrahieren.
Barrierefreiheit
Gedruckte Inhalte für Screenreader zugänglich machen.
Übersetzung
Text für Übersetzungsdienste extrahieren.
Dokumentenprüfung in Gerichtsverfahren
Gescannte juristische Dokumente durchsuchen.
Bankwesen
Schecks und Finanzdokumente verarbeiten.
OCR ausprobieren
Verwenden Sie Bild in Text mit einer einzelnen Datei im Format JPG/JPEG, PNG, WebP, GIF, BMP oder TIFF. Wählen Sie vor dem Absenden eine der 15 Sprachen für die Texterkennung. Zu Beginn ist Englisch ausgewählt. Die Erkennung erfolgt auf dem Server. Vergleichen Sie das Ergebnis mit dem Bild und kopieren Sie anschließend den reinen Text oder laden Sie ihn herunter. Das Tool übersetzt den Text nicht und rekonstruiert auch nicht das Dokumentlayout.
PDF-Dateien werden hier nicht als Eingabe akzeptiert. Verwenden Sie zuerst PDF in Bilder umwandeln und lassen Sie die benötigten Seitenbilder einzeln erkennen. Die Bildgrenzen betragen 20 MB, 8192 px pro Seite und 25 Millionen Pixel. Alle diese Grenzen gelten gleichzeitig.
OCR im Vergleich zur manuellen Dateneingabe
| Aspekt | OCR | Manuelle Eingabe |
|---|---|---|
| Geschwindigkeit | Sekunden | Minuten oder Stunden |
| Kosten | Kostenlos bis gering | Arbeitskosten |
| Genauigkeit | Abhängig vom Bild und Erkennungsmodell | Abhängig von der Aufgabe und der Korrekturprüfung |
| Kapazität | Begrenzt durch Dateien, Verarbeitungsressourcen und Anfragelimits | Begrenzt durch verfügbare Zeit und Personal |
| Gleichmäßige Ergebnisqualität | Hoch | Schwankend |
Grenzen der OCR
Abhängigkeit von der Qualität
Schlechte Bildqualität verringert die Erkennungsgenauigkeit erheblich.
Schwierigkeiten bei Handschrift
Unterschiedliche Handschriften sind schwer zu erkennen.
Komplexe Layouts
Tabellen, Spalten und gemischte Inhalte können die OCR-Erkennung beeinträchtigen.
Sprachliche Einschränkungen
Einige Sprachen und Schriftsysteme werden besser unterstützt als andere.
Die Zukunft der OCR
Einbindung von KI
Deep Learning verbessert die Genauigkeit und die Fähigkeiten kontinuierlich.
Verarbeitung in Echtzeit
Mobilgeräte bieten inzwischen unmittelbare OCR-Texterkennung in der Kameraansicht.
Multimodale Erkennung
Bild-, Text- und Layoutverständnis werden miteinander verbunden.
Verarbeitung in der Cloud
Leistungsfähige OCR ist über Webdienste verfügbar.
Häufig gestellte Fragen
Ist OCR zu 100 % genau?
Die Erkennungsgenauigkeit hängt vom Ausgangsbild, der Sprache, der Schrift und dem Layout ab. Hier wird kein fester Prozentsatz zugesagt. Vergleichen Sie eine repräsentative Stichprobe mit dem Original, insbesondere Namen und Zahlen. Der Konfidenzwert eines Modells ist keine gemessene Genauigkeitsrate auf Zeichenebene.
Kann OCR jede Schriftart lesen?
Die meisten Standardschriftarten funktionieren gut. Bei dekorativen oder ungewöhnlichen Schriften kann die Genauigkeit geringer sein.
Funktioniert OCR bei Handschrift?
Ja, die Genauigkeit hängt jedoch stark davon ab, wie gut lesbar die Handschrift ist.
Ist OCR dasselbe wie Textextraktion?
OCR erkennt Zeichen anhand von Pixeln. Textextraktion ist der weiter gefasste Begriff: Sie kann auch bereits eingebetteten Text aus einer digitalen PDF-Datei auslesen, ohne ein Bild zu erkennen. Das OCR-Formular auf dieser Website akzeptiert Bilder. Wandeln Sie eine gescannte PDF-Seite deshalb zunächst in ein Bild um.
Kann OCR mehrere Sprachen erkennen?
Manche OCR-Systeme unterstützen eine automatische Spracherkennung oder mehrere Erkennungssprachen gleichzeitig. Hier wählen Sie eine von 15 Sprachen manuell aus. Eine automatische Erkennung und die gemeinsame Auswahl mehrerer Sprachen werden nicht angeboten. Prüfen Sie gemischtsprachige Texte sorgfältig oder verarbeiten Sie geeignete Bildausschnitte getrennt.
Fazit
OCR hat den Umgang mit gedrucktem und handschriftlichem Text grundlegend verändert. Probieren Sie unser kostenloses OCR-Tool aus und erleben Sie die Technologie selbst.
Weitere Tools: Bild in Text | PDF-Konverter | Dokument-Tools
Weitere Tools für Ihre nächsten Bildaufgaben
Entdecken Sie die ImgConvert-Tools zum Umwandeln sowie für PDF-Dateien und GIFs.
- Bildkonverter
- PDF-Tools
- GIF-Tools