OCR-Texterkennung: Was ist OCR und wie funktioniert sie?
Wenn Sie einen Beleg fotografieren und die Beträge automatisch in eine Spesen-App übernommen werden oder Sie eine Visitenkarte aufnehmen und die Kontaktdaten auf Ihrem Smartphone landen, erleben Sie OCR in Aktion. Die optische Zeichenerkennung gehört zu den Technologien, die fast unbemerkt unverzichtbar geworden sind. Sie begegnet uns überall, doch nur wenige wissen, wie sie tatsächlich funktioniert.
Dieser Ratgeber erklärt, was OCR ist, welche Technik dahintersteckt, wo sie eingesetzt wird und welche Grenzen sie hat.
Die folgenden Abschnitte erläutern OCR-Technologie im Allgemeinen. Funktionen wie die Rekonstruktion des Layouts, Übersetzung, automatische Spracherkennung und Modelle für Handschrift unterscheiden sich je nach Produkt. Das Tool „Bild in Text“ auf dieser Website extrahiert reinen Text aus einem einzelnen Bild mit einer manuell ausgewählten Sprache. Die genannten weitergehenden Funktionen bietet es nicht.
Was ist OCR?
OCR steht für Optical Character Recognition, auf Deutsch „optische Zeichenerkennung“. Mit dieser Technologie können Computer Text in Bildern, gescannten Dokumenten und Fotos erkennen und extrahieren. Dabei wird sichtbarer Text in maschinenlesbaren digitalen Text umgewandelt.
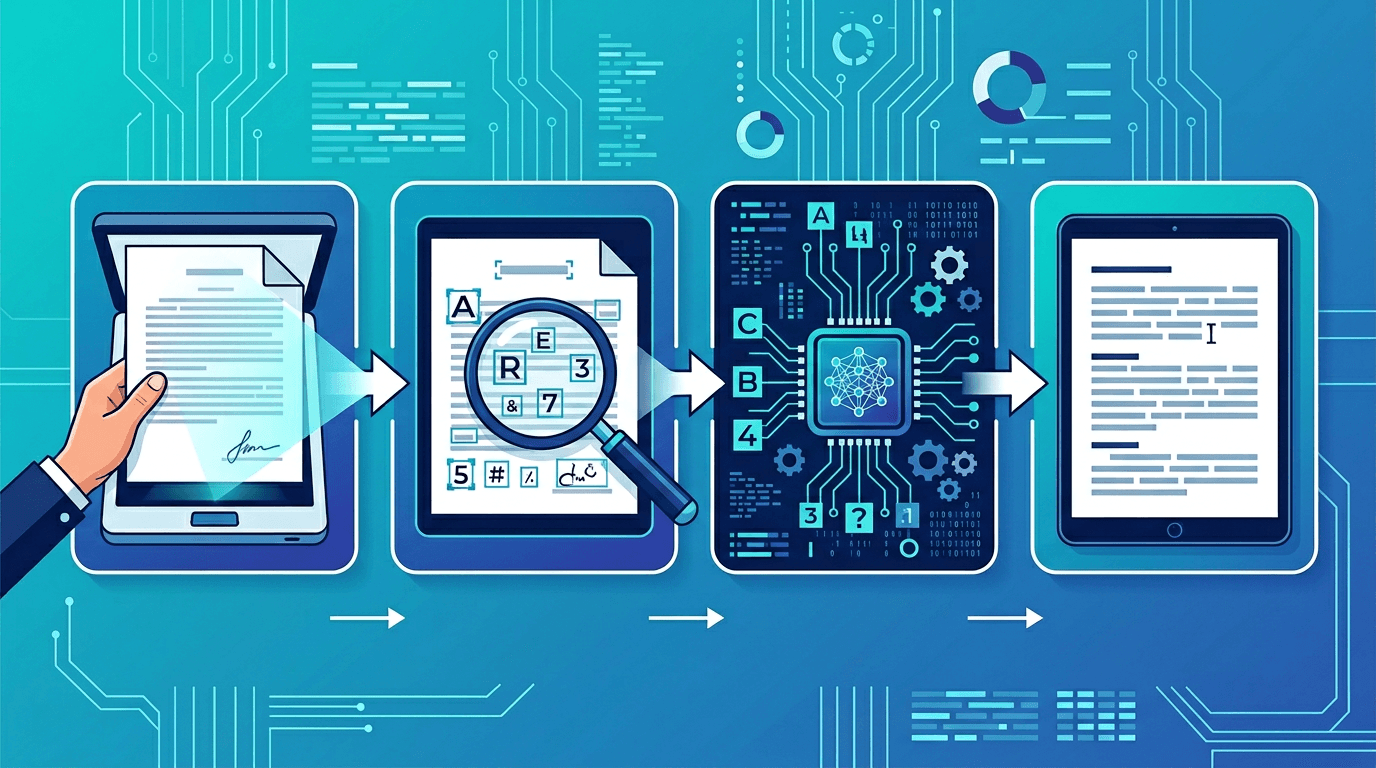
Im Kern erfüllt OCR vier Aufgaben:
- Text erkennen — in Bildern, gescannten Dokumenten und Fotos
- Sichtbaren Text umwandeln — in ein digitales, bearbeitbares und durchsuchbares Format
- Die Suche ermöglichen — in zuvor nicht durchsuchbaren bildbasierten Inhalten
- Die Dateneingabe automatisieren — durch das Extrahieren von Informationen aus Papierdokumenten
Vor OCR war das Foto eines Dokuments lediglich ein Foto. Für einen Computer war der darin abgebildete Text als solcher nicht zugänglich. OCR verbindet die physische Welt gedruckter Texte mit der digitalen Welt durchsuchbarer und verarbeitbarer Daten.
Wie funktioniert OCR?
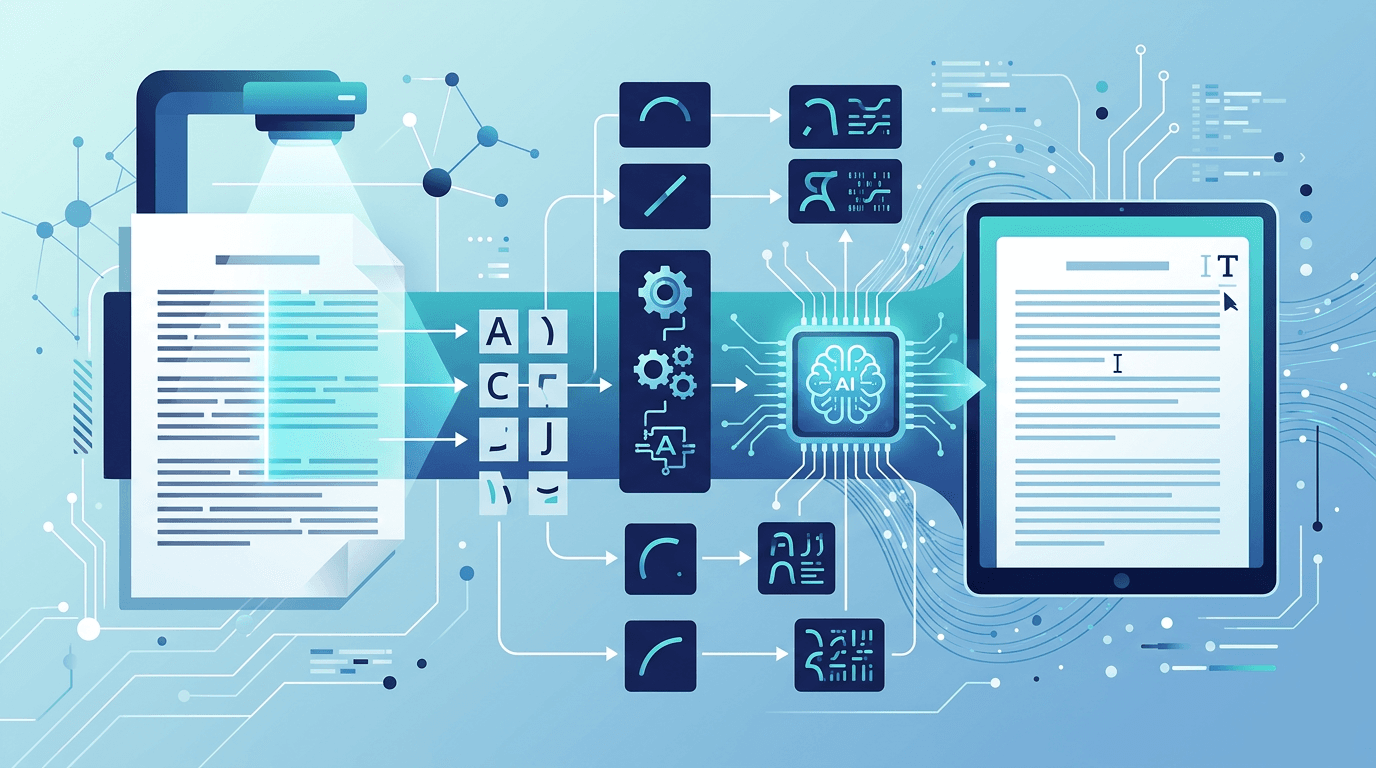
Moderne OCR umfasst eine komplexe Abfolge von Verarbeitungsschritten. Wer diese Schritte kennt, versteht besser, warum OCR unter guten Bedingungen so genau arbeitet und unter schwierigen Bedingungen an Grenzen stößt.
Phase 1: Bilderfassung
Der Vorgang beginnt mit dem Erfassen oder Importieren eines Bildes:
- Einscannen eines Papierdokuments mit einem Flachbett- oder Dokumentenscanner
- Fotografieren von Text mit einer Smartphone-Kamera
- Erstellen eines Screenshots von Bildschirminhalten
- Importieren einer vorhandenen Datei (JPG, PNG, PDF, TIFF usw.)
Die Qualität in dieser Phase ist entscheidend: Sie bestimmt, was die nachfolgenden Schritte erreichen können. Ein unscharfes oder schlecht beleuchtetes Foto liefert schlechtere Ergebnisse als ein sauberer, hochauflösender Scan.
Phase 2: Bildvorverarbeitung
Vor der eigentlichen Zeichenerkennung wird das Bild in mehreren Schritten aufbereitet:
- Binarisierung: Wandelt das Bild in reines Schwarz-Weiß um. Dadurch entfallen Farbinformationen, und das vereinfachte Bild erleichtert die Unterscheidung zwischen Text und Hintergrund.
- Rauschunterdrückung: Entfernt Flecken, Körnung und Bildartefakte, die mit Zeichen verwechselt werden könnten.
- Schräglagenkorrektur: Richtet schiefe oder gedrehte Dokumente aus. Wenn Sie eine Seite leicht schräg fotografieren, wird sie in diesem Schritt begradigt.
- Entfernen von Störpunkten: Beseitigt kleine, zufällig verteilte Punkte im Bild.
- Layoutanalyse: Erkennt und trennt unterschiedliche Bereiche wie Haupttext, Kopfzeilen, Randspalten, Tabellen und Bilder, damit jeder Bereich passend verarbeitet werden kann.
Phase 3: Zeichenerkennung
Hier findet die eigentliche Texterkennung statt. Moderne OCR-Systeme nutzen mehrere Ansätze gleichzeitig:
Musterabgleich: Vergleicht einzelne Zeichen mit einer Sammlung bekannter Zeichenformen. Das ist besonders bei klar definierten Standardschriftarten wirksam.
Merkmalserkennung: Untersucht charakteristische Strukturen jedes Zeichens, etwa Rundungen, Schnittpunkte und geschlossene Innenräume. Der Buchstabe „B“ hat beispielsweise rechts zwei geschlossene Rundungen, der Buchstabe „P“ nur eine. Anhand dieser Merkmale lassen sich Zeichen auch dann erkennen, wenn ihre genaue Form variiert.
Neuronale Netze: Moderne OCR-Systeme verwenden Deep-Learning-Modelle, die anhand von Millionen Textbeispielen trainiert wurden. Sie haben gelernt, Zeichen in sehr unterschiedlichen Schriftarten, Größen, Handschriften und Bildbedingungen zu erkennen.
Kontextanalyse: Nach der Erkennung einzelner Zeichen verbessert eine sprachliche Analyse das Ergebnis. Wurde beispielsweise „h0use“ statt „house“ erkannt, kann das Sprachmodell anhand der umgebenden Wörter und sprachlichen Muster ableiten, dass die „0“ hier eher ein „o“ ist.
Phase 4: Nachverarbeitung
In der letzten Phase werden die Ergebnisse verbessert und für die Ausgabe aufbereitet:
- Rechtschreibprüfung: Markiert und korrigiert offensichtliche Fehler durch den Abgleich mit einem Wörterbuch
- Layouterhalt: Bewahrt die strukturelle Formatierung des Originaldokuments, etwa Spalten, Tabellen und Absatzumbrüche
- Konfidenzbewertung: Weist jedem erkannten Zeichen oder Wort einen prozentualen Konfidenzwert zu, damit Anwendungen unsichere Ergebnisse für eine manuelle Prüfung markieren können
- Ausgabeformatierung: Exportiert die Ergebnisse im gewünschten Format, etwa als reinen Text, durchsuchbare PDF-Datei, Word-Dokument oder strukturierte Daten
Arten der OCR-Technologie
Standard-OCR
Die ursprüngliche und am weitesten verbreitete Form:
- Erkennt gedruckten Text in Standardschriftarten
- Liefert die besten Ergebnisse bei sauberen, hochwertigen Bildern und guter Beleuchtung
- Erzielt die höchste Genauigkeit bei der Verarbeitung formaler Dokumente
- Funktioniert mit dem Großteil gedruckter Materialien
Intelligente Zeichenerkennung (ICR)
Eine speziell für handschriftliche Texte entwickelte Erweiterung:
- Nutzt fortgeschrittenes maschinelles Lernen für unterschiedliche Handschriften
- Verbessert sich fortlaufend durch zusätzliche Beispiele
- Ist weiterhin weniger genau als Standard-OCR bei gedrucktem Text
- Wird bei der Verarbeitung von Bankschecks, der Digitalisierung historischer Dokumente und der Formularverarbeitung eingesetzt
Intelligente Worterkennung (IWR)
Erkennt ganze Wörter statt einzelner Zeichen und verfolgt damit einen ganzheitlichen Ansatz:
- Ist wirksamer bei Schreibschrift und verbundenen Buchstaben, die ineinander übergehen
- Verbessert die Genauigkeit durch die Berücksichtigung des Kontexts
- Wird für natürlichsprachlichen Text mit Sprachmodellen kombiniert
- Wird bei der Postsortierung und der Digitalisierung von Formularen eingesetzt
Optische Markierungserkennung (OMR)
Eine spezialisierte Variante zur Erkennung von Markierungen statt zum Lesen von Text:
- Erkennt Kontrollkästchen, Antwortfelder und Markierungen, sowohl ausgefüllt als auch leer
- Wird bei standardisierten Tests, Umfragen und beim Scannen von Stimmzetteln eingesetzt
- Unterscheidet binär zwischen markiert und nicht markiert
- Erreicht bei guter Bildqualität eine sehr hohe Genauigkeit
Barcode- und QR-Code-Erkennung
Diese verwandten Technologien sind technisch von der OCR-Texterkennung getrennt und erfüllen folgende Aufgaben:
- Lesen 1D- und 2D-Barcodes
- Decodieren QR-Codes
- Extrahieren codierte Daten statt sichtbaren Text
- Sind in viele Anwendungen mit OCR-Funktion integriert
Was beeinflusst die Genauigkeit der OCR?
Wenn Sie wissen, unter welchen Bedingungen OCR gut oder schlecht funktioniert, können Sie bessere Ergebnisse erzielen:
| Faktor | Einfluss auf die Genauigkeit | Hinweise |
|---|---|---|
| Bildauflösung | Hoch | Genügend Pixel, um jedes Zeichen zu unterscheiden; eine DPI-Angabe allein reicht nicht aus |
| Bildschärfe | Sehr hoch | Unschärfe beeinträchtigt die Qualität am stärksten |
| Textkontrast | Hoch | Dunkler Text auf hellem Hintergrund ist ideal |
| Schriftart | Mittel bis hoch | Standardschriftarten > dekorative Schriften |
| Dokumentzustand | Mittel | Knicke, Flecken und Beschädigungen verringern die Genauigkeit |
| Sprachliche Komplexität | Mittel | Lateinische Schriftsysteme sind leichter zu erkennen als komplexe Schriftsysteme |
| Handschrift | Hoch | Individuelle Unterschiede erschweren die Erkennung |
| Beleuchtung | Hoch | Ungleichmäßige Beleuchtung erzeugt Schatten und Artefakte |
OCR in der Praxis
OCR dient nicht nur einem einzelnen Zweck. Sie ist eine grundlegende Technologie für Dutzende Anwendungen in vielen Branchen:
Dokumentendigitalisierung
Bibliotheken, Kanzleien, Behörden und Unternehmen nutzen OCR, um jahrzehntelang gesammelte Papierunterlagen in durchsuchbare digitale Archive umzuwandeln. Ein Dokument, für das früher Aktenschränke manuell durchsucht werden mussten, lässt sich über die Volltextsuche in Sekunden finden.
Automatisierte Dateneingabe
Statt Daten aus Rechnungen, Bestellungen oder Formularen von Hand in Datenbanken einzutragen, werden die Informationen per OCR automatisch extrahiert. Das wird besonders häufig in der Kreditorenbuchhaltung, bei der Bearbeitung von Versicherungsfällen und in der Verwaltung medizinischer Unterlagen eingesetzt.
Barrierefreiheit
OCR kann lesbaren Text für assistive Technologien bereitstellen. Eine barrierefreie PDF-Datei benötigt außerdem eine korrekte Lesereihenfolge und Dokumentstruktur. Die OCR-Technik des W3C umfasst diese Prüfungen. Diese Website exportiert reinen Text und keine mit Struktur-Tags versehene PDF-Datei.
Übersetzungsdienste
Übersetzungs-Apps verwenden OCR, um Text vor der Übersetzung aus Bildern zu extrahieren. Wenn Sie Ihre Kamera auf eine fremdsprachige Speisekarte richten, erfasst OCR den Text für die unmittelbare Übersetzung.
Dokumentenprüfung in Gerichtsverfahren
Bei Rechtsstreitigkeiten müssen juristische Teams Tausende Dokumente durchsuchen. OCR wandelt gescannte Dokumente in durchsuchbaren Text um. So lassen sich ganze Dokumentensammlungen nach bestimmten Begriffen oder Formulierungen durchsuchen.
Finanzdienstleistungen
OCR kann gedruckte Kontonummern oder Beträge aus Dokumentbildern extrahieren. Die Zeichenerkennung prüft jedoch weder eine Unterschrift noch die Echtheit eines Dokuments. Dafür ist ein gesondertes Verfahren nötig. Diese Website bietet ausschließlich Textextraktion.
Gesundheitswesen
Bei der Verwaltung medizinischer Unterlagen wird OCR zunehmend eingesetzt, um handschriftliche Notizen, Laborberichte und Rezepte in strukturierte elektronische Datensätze umzuwandeln. Das verbessert die Genauigkeit der Dokumentation und ermöglicht eine bessere Datenanalyse.
Grenzkontrolle und Sicherheit
Reisepässe, Ausweise und Visa enthalten maschinenlesbare Zonen (MRZ), die OCR-Systeme an Grenzübergängen automatisch auslesen. Das beschleunigt die Abfertigung und verbessert die Genauigkeit der Überprüfung.
OCR selbst ausprobieren
Verwenden Sie Bild in Text mit einer einzelnen Datei im Format JPG/JPEG, PNG, WebP, GIF, BMP oder TIFF. Wählen Sie vor dem Absenden eine der 15 Sprachen für die Texterkennung. Zu Beginn ist Englisch ausgewählt. Die Erkennung erfolgt auf dem Server. Vergleichen Sie das Ergebnis mit dem Bild und kopieren Sie anschließend den reinen Text oder laden Sie ihn herunter. Das Tool übersetzt den Text nicht und rekonstruiert auch nicht das Dokumentlayout.
PDF-Dateien werden hier nicht als Eingabe akzeptiert. Verwenden Sie zuerst PDF in Bilder umwandeln und lassen Sie die benötigten Seitenbilder einzeln erkennen. Die Bildgrenzen betragen 20 MB, 8192 px pro Seite und 25 Millionen Pixel. Alle diese Grenzen gelten gleichzeitig.
OCR im Vergleich zur manuellen Dateneingabe
Wie schneidet OCR im Vergleich dazu ab, Dokumentinhalte von Hand abzutippen?
| Aspekt | OCR | Manuelle Dateneingabe |
|---|---|---|
| Geschwindigkeit | Sekunden pro Seite | Minuten bis Stunden pro Seite |
| Kosten | Kostenlos bis gering | Arbeitskosten pro Seite oder Stunde |
| Genauigkeit | Abhängig vom Bild und Erkennungsmodell | Abhängig von der Aufgabe und der Korrekturprüfung |
| Kapazität | Begrenzt durch Dateien, Verarbeitungsressourcen und Anfragelimits | Begrenzt durch verfügbare Zeit und Personal |
| Gleichmäßige Ergebnisqualität | Hoch | Schwankend durch Müdigkeit und Ablenkung |
| Verfügbarkeit | 24/7 | Geschäftszeiten |
Bei großen Dokumentenmengen hat OCR in puncto Geschwindigkeit und Kosten klare Vorteile. Bei wenigen, sehr komplexen Dokumenten, die eine inhaltliche Auslegung statt einer reinen Abschrift erfordern, bleibt die menschliche Prüfung wertvoll.
Grenzen und Herausforderungen der OCR
Trotz erheblicher Fortschritte ist OCR nicht fehlerfrei. Wenn Sie ihre Grenzen kennen, können Sie die Ergebnisse realistisch einschätzen:
Abhängigkeit von der Bildqualität
Bei schlechter Bildqualität nimmt die Erkennungsgenauigkeit stark ab. Niedrige Auflösung, unscharfe Fotos, schlechte Beleuchtung und starke Komprimierung beeinträchtigen das Ergebnis. Hier gilt besonders: Schlechte Eingangsdaten führen zu schlechten Ergebnissen.
Unterschiedliche Handschriften
Moderne OCR kann zwar viele Handschriften verarbeiten, individuelle Unterschiede bleiben aber eine Herausforderung. Ungewöhnliche Buchstabenformen, ungleichmäßige Abstände und stark stilisierte Schrift können Erkennungsalgorithmen verwirren.
Verarbeitung komplexer Layouts
Mehrspaltige Layouts, Tabellen, Fußnoten und Dokumente mit gemischten Inhalten erfordern eine anspruchsvolle Layoutanalyse. OCR kann Schwierigkeiten haben, wenn Text um Bilder herumfließt oder Spalten nicht klar voneinander getrennt sind.
Unterstützung von Sprachen und Schriftsystemen
Weitverbreitete Sprachen mit lateinischem Alphabet werden von OCR in der Regel sehr gut unterstützt. Weniger verbreitete Sprachen, von rechts nach links verlaufende Schriften wie Arabisch und Hebräisch sowie komplexe Zeichensysteme wie Chinesisch, Japanisch und Koreanisch erforderten früher spezielle OCR-Systeme. Moderne KI-Systeme haben diesen Abstand allerdings deutlich verringert.
Mathematische Formeln und Sonderzeichen
Technische Dokumente mit mathematischer Notation, chemischen Formeln oder ungewöhnlichen Symbolen können OCR-Systeme vor Probleme stellen, wenn diese nicht gezielt dafür trainiert wurden.
Die Zukunft der OCR-Technologie
Einbindung von KI und Deep Learning
Neuronale Netzmodelle für OCR werden jedes Jahr leistungsfähiger. Moderne Systeme erreichen Erkennungsraten, die mit herkömmlichem Musterabgleich nicht möglich gewesen wären. Der Trend zu Transformer-Architekturen, auf denen auch große Sprachmodelle beruhen, verbessert die OCR-Genauigkeit weiter.
Mobile OCR in Echtzeit
Moderne Smartphones können OCR in Echtzeit direkt im Sucher der Kamera ausführen. Google Lens, Apples Live Text und ähnliche Funktionen zeigen, dass OCR inzwischen schnell genug ist, um den laufenden Videostream eines Mobilgeräts zu verarbeiten.
Multimodales Dokumentverständnis
Der nächste Entwicklungsschritt besteht darin, nicht nur Text zu erkennen, sondern die gesamte Struktur und Bedeutung eines Dokuments zu verstehen: Tabellen, Diagramme und die Beziehungen zwischen Text und Bildern. KI-Systeme, die Bild- und Sprachverständnis verbinden, nähern sich bei komplexen Dokumenten dem menschlichen Verständnis an.
OCR-Dienste aus der Cloud
API-basierte OCR-Dienste großer Cloud-Anbieter wie Google Cloud Vision, AWS Textract und Azure Computer Vision machen OCR für Unternehmensanwendungen allen Entwicklern mit einem API-Schlüssel zugänglich. Diese Dienste verbessern sich weiter, während sie Milliarden Dokumente verarbeiten.
Häufig gestellte Fragen
Ist OCR zu 100 % genau?
Die Erkennungsgenauigkeit hängt vom Ausgangsbild, der Sprache, der Schrift und dem Layout ab. Hier wird kein fester Prozentsatz zugesagt. Vergleichen Sie eine repräsentative Stichprobe mit dem Original, insbesondere Namen und Zahlen. Der Konfidenzwert eines Modells ist keine gemessene Genauigkeitsrate auf Zeichenebene.
Kann OCR jede Schriftart erkennen?
Die meisten Standardschriftarten wie Times New Roman, Arial und Helvetica funktionieren sehr gut. Stark dekorative Schriften, Schreibschriftarten oder ungewöhnliche Schriftarten können zu niedrigeren Erkennungsraten führen. OCR wurde traditionell für gängige Geschäfts- und Druckschriften optimiert.
Funktioniert OCR bei Handschrift?
Ja, mit Einschränkungen. Handschrift in Druckbuchstaben funktioniert deutlich besser als verbundene Schreibschrift. Moderne KI-basierte OCR hat die Handschrifterkennung erheblich verbessert, die Genauigkeit hängt aber weiterhin stark vom individuellen Schreibstil ab.
Was unterscheidet OCR von der Textextraktion aus PDF-Dateien?
Die PDF-Textextraktion liest eingebetteten digitalen Text aus elektronisch erstellten PDF-Dateien, etwa aus einem als PDF gespeicherten Word-Dokument. Dafür ist keine Zeichenerkennung nötig, weil die Textdaten bereits vorliegen. OCR wird bei gescannten Dokumenten, Fotos und durch Einscannen erstellten PDF-Dateien benötigt, in denen der Text nur als Pixel vorhanden ist.
Kann OCR mehrere Sprachen in einem Dokument erkennen?
Manche OCR-Systeme unterstützen eine automatische Spracherkennung oder mehrere Erkennungssprachen gleichzeitig. Hier wählen Sie eine von 15 Sprachen manuell aus. Eine automatische Erkennung und die gemeinsame Auswahl mehrerer Sprachen werden nicht angeboten. Prüfen Sie gemischtsprachige Texte sorgfältig oder verarbeiten Sie geeignete Bildausschnitte getrennt.
Wie geht OCR mit Tabellen und strukturierten Daten um?
Manche Systeme zur Dokumentenverarbeitung rekonstruieren Tabellen. Dieses Tool gibt reinen Text zurück, sodass Spalten oder Zellgrenzen verloren gehen können. Vergleichen Sie die Lesereihenfolge und die Zahlen mit dem Original und erstellen Sie die Tabelle bei Bedarf in einem geeigneten Editor neu.
Zusammenfassung
OCR hat sich fast unbemerkt zu einer der einflussreichsten Technologien des digitalen Zeitalters entwickelt. Sie verbindet die physische und die digitale Welt und macht die großen Informationsmengen in gedruckten und handschriftlichen Texten zugänglich, durchsuchbar und verarbeitbar.
Von der Dokumentendigitalisierung bis zur Übersetzung in Echtzeit, von medizinischen Unterlagen bis zur Grenzsicherheit: OCR spielt in mehr Bereichen des Alltags eine Rolle, als vielen bewusst ist.
Probieren Sie unser kostenloses OCR-Tool selbst aus: Laden Sie ein Bild mit Text hoch und erleben Sie die Technologie in der Praxis.
Weitere Tools: Bild in Text | PDF in Bilder umwandeln | Bild in PDF
Weitere Tools für Ihre nächsten Bildaufgaben
Entdecken Sie die ImgConvert-Tools zum Umwandeln sowie für PDF-Dateien und GIFs.
- Bildkonverter
- PDF-Tools
- GIF-Tools