OCR 是什麼?光學字元辨識技術完整指南
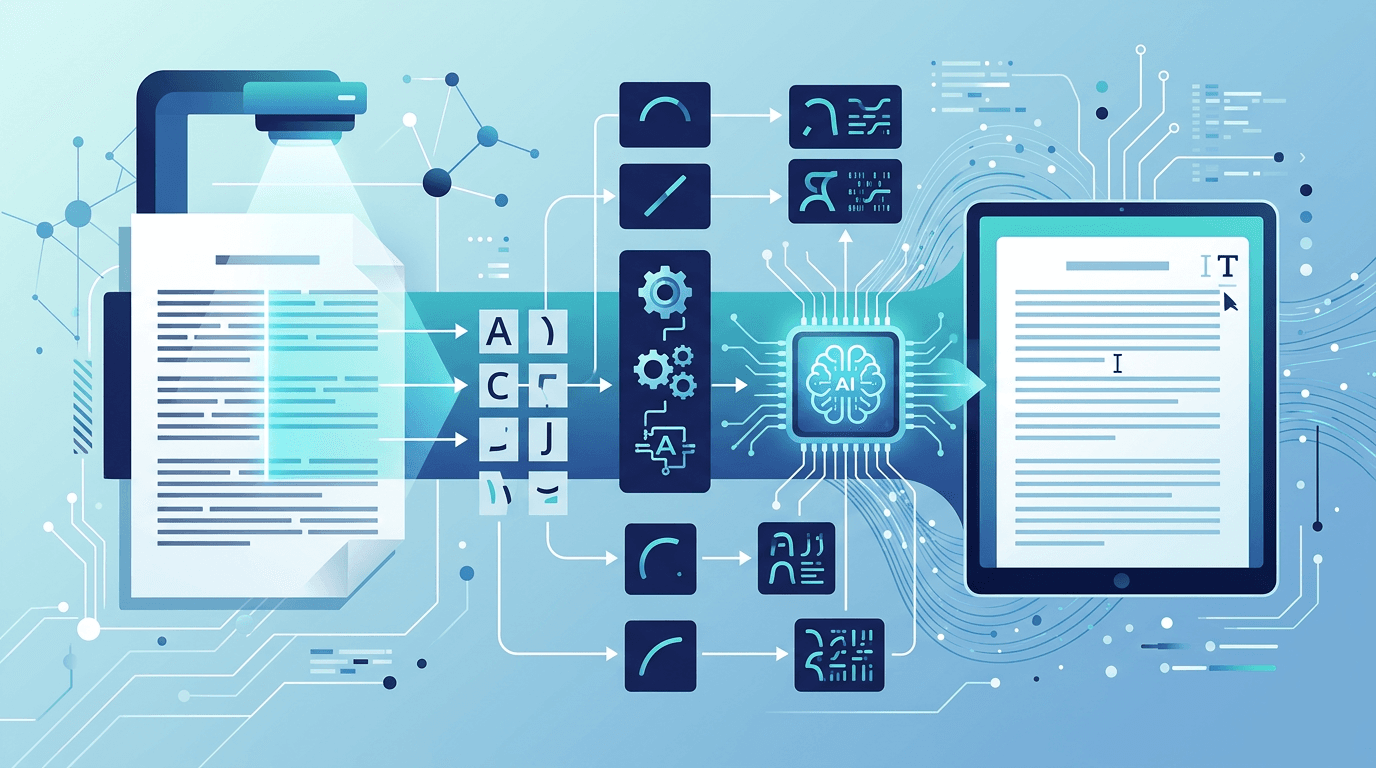
當您拍下收據,讓記帳應用程式自動填入金額,或拍攝名片後將聯絡資料匯入手機時,就是在使用 OCR。光學字元辨識這項技術早已悄悄成為生活中不可或缺的一部分;雖然無所不在,多數人卻不太了解它實際如何運作。
這篇指南會說明 OCR 是什麼、背後的技術、應用情境,以及它的限制。
以下章節介紹的是一般 OCR 技術。版面重建、翻譯、自動語言偵測與手寫辨識模型等功能,會因產品而異。本站的圖片轉文字工具,是以手動選擇的一種語言,從單張圖片擷取純文字;並不提供上述更廣泛的功能。
OCR 是什麼?
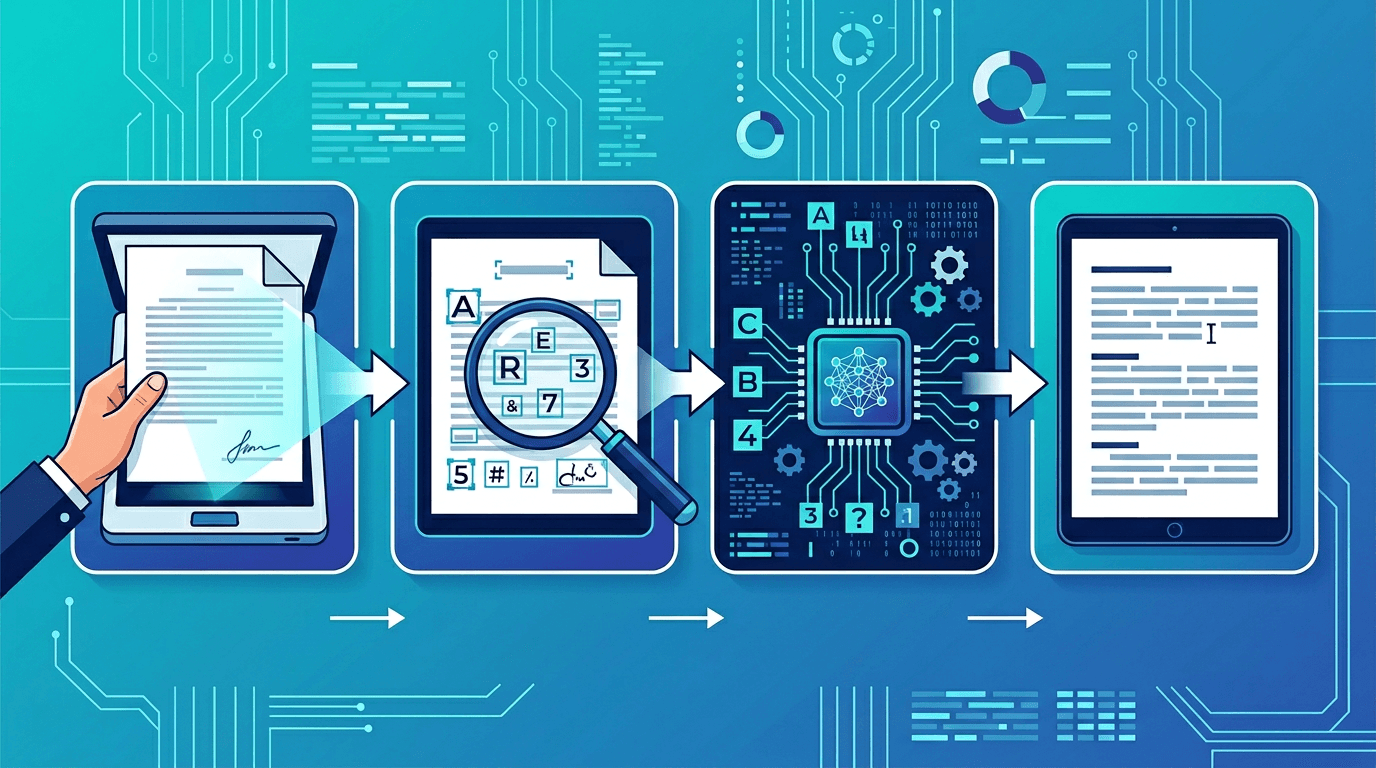
OCR 是 Optical Character Recognition(光學字元辨識)的縮寫。這項技術讓電腦能辨識並擷取圖片、掃描文件與照片中的文字,將視覺上的文字轉成機器可讀取的數位文字。
OCR 的核心用途有四項:
- 辨識文字 — 找出圖片、掃描文件與照片中的文字
- 轉換視覺文字 — 轉成可編輯、可搜尋的數位格式
- 支援搜尋 — 讓原本無法搜尋的圖片內容可以被檢索
- 自動輸入資料 — 從紙本文件擷取資訊
在 OCR 出現之前,文件照片對電腦來說就只是一張照片,裡面的文字幾乎等同不存在。OCR 連結了紙本印刷文字與可搜尋、可處理的數位資料。
OCR 技術如何運作
現代 OCR 需要經過一連串複雜的處理流程。了解這些階段,有助於理解為什麼 OCR 在良好條件下能準確辨識,遇到困難情況卻容易出錯。
階段 1:取得圖片
流程從拍攝、掃描或匯入圖片開始:
- 使用平台式掃描器或文件掃描器掃描紙本文件
- 使用智慧型手機相機拍攝文字
- 擷取螢幕上的內容
- 匯入現有圖片檔案(JPG、PNG、PDF、TIFF 等)
這個階段的品質非常關鍵,會決定後續處理的上限。模糊或光線不足的照片,辨識結果會比清晰、高解析度的掃描圖片差。
階段 2:圖片前處理
開始辨識字元前,圖片會先經過數種改善處理:
- 二值化: 將圖片轉成純黑與純白,移除色彩資訊並簡化畫面,讓文字與背景更容易區分。
- 降低雜訊: 移除可能被誤認為字元的斑點、顆粒與影像瑕疵。
- 傾斜校正: 校正傾斜或旋轉的文件。如果拍攝頁面時有些歪斜,這個步驟會將其拉正。
- 去除斑點: 移除圖片中隨機分布的小點。
- 版面分析: 辨識並分隔內文、頁首、側欄、表格與圖片等不同區域,讓各區域得到適當處理。
階段 3:字元辨識
這個階段才真正開始辨識文字。現代 OCR 引擎會同時運用多種方法:
模式比對: 將個別字元與已知字形資料庫比較,適合標準且形狀清楚的字型。
特徵偵測: 分析每個字元特有的結構,例如曲線、交叉點與封閉空間。舉例來說,字母「B」右側有兩個封閉區域,「P」則只有一個。即使字形不完全相同,仍可透過這些結構特徵辨識字元。
神經網路: 現代 OCR 引擎採用以數百萬筆文字樣本訓練的深度學習模型。這些模型已學會在各種字型、大小、手寫風格與圖片條件下辨識字元。
上下文分析: 辨識個別字元後,再透過語言分析改善結果。如果字元偵測將「house」辨識成「h0use」,語言模型會依周圍詞語與語言模式,判斷這裡的「0」更可能是「o」。
階段 4:後處理
最後一個階段會修正並整理輸出:
- 拼字檢查: 查詢字典,標示並修正明顯錯誤
- 版面保留: 維持原始文件的結構格式,例如分欄、表格與段落換行
- 信心評分: 為每個辨識出的字元或詞語提供信心百分比,讓應用程式能標示低信心結果,交由人工檢查
- 輸出格式設定: 依需要匯出為純文字、可搜尋的 PDF、Word 文件或結構化資料
OCR 技術的類型
標準 OCR
最早、也是最常見的類型:
- 辨識使用標準字型的印刷文字
- 適合清晰、高品質且光線充足的圖片
- 處理正式文件時最準確
- 適用於絕大多數印刷材料
智慧字元辨識(ICR)
專為手寫文字發展的進階技術:
- 使用進階機器學習處理多樣的手寫風格
- 接觸更多範例後會持續改善
- 準確度仍低於標準 OCR 對印刷文字的辨識
- 用於銀行支票處理、歷史文件數位化與表單處理
智慧詞彙辨識(IWR)
以整體方式辨識完整詞語,而非逐一辨識字元:
- 對字元彼此相連的草寫與連筆字更有效
- 結合上下文的處理方式可提升準確度
- 搭配語言模型處理自然文字
- 用於郵件分類與表單數位化
光學標記辨識(OMR)
專門偵測標記,而非閱讀文字的技術:
- 辨識核取方塊、答案圓格與標記是否填入
- 用於標準化測驗、問卷與選票掃描
- 二元判斷:有標記或無標記
- 圖片品質良好時,準確度非常高
條碼與 QR Code 辨識
雖然在技術上與文字 OCR 不同,這些相關技術可以:
- 讀取一維與二維條碼
- 解碼 QR Code
- 擷取編碼資料,而非視覺上的文字
- 整合進許多具備 OCR 功能的應用程式
影響 OCR 準確度的因素
了解哪些條件有助於或不利於 OCR,可幫助您得到更好的結果:
| 因素 | 對準確度的影響 | 說明 |
|---|---|---|
| 圖片解析度 | 高 | 需要足夠的像素區分每個字元;只有 DPI 標籤並不足夠 |
| 圖片清晰度 | 非常高 | 模糊是最主要的品質問題 |
| 文字對比 | 高 | 淺色背景搭配深色文字最理想 |
| 字型類型 | 中至高 | 標準字型 > 裝飾字型 |
| 文件狀況 | 中 | 摺痕、污漬與破損會降低準確度 |
| 語言複雜度 | 中 | 拉丁字母系統比複雜文字系統容易辨識 |
| 手寫文字 | 高 | 個人書寫差異增加辨識難度 |
| 光線 | 高 | 不均勻的光線會產生陰影與影像瑕疵 |
OCR 的實際應用
OCR 的用途不只一種,它是支援許多產業、多種應用的基礎技術:
文件數位化
圖書館、律師事務所、政府機關與企業使用 OCR,將數十年的紙本紀錄轉成可搜尋的數位檔案。過去需要翻找文件櫃的資料,現在透過全文檢索,幾秒內就能找到。
自動輸入資料
OCR 可自動擷取發票、採購單或表單中的資訊,省去人工輸入資料庫的工作。這類應用常見於應付帳款、保險理賠與醫療紀錄管理。
無障礙應用
OCR 可為輔助科技提供可讀取的文字。無障礙 PDF 還需要正確的閱讀順序與文件結構;W3C 的 OCR 技術說明也包含這些檢查。本站匯出的是純文字,並非含有標籤的 PDF。
翻譯服務
翻譯應用程式會先使用 OCR 擷取圖片中的文字,再進行翻譯。將相機對準外文菜單,OCR 就能擷取文字,供即時翻譯使用。
訴訟證據開示
在訴訟中,法律團隊必須檢索成千上萬份文件。OCR 可將掃描文件轉成可搜尋的文字,讓團隊在整批文件中查找特定詞語或片語。
金融服務
OCR 可協助從文件圖片擷取印刷的帳號或金額。辨識字元不代表能驗證簽名或判定文件真偽;這些檢查需要另外的流程。本站只提供文字擷取功能。
醫療照護
醫療紀錄管理越來越常使用 OCR,將手寫筆記、檢驗報告與處方轉成結構化電子紀錄。這能改善紀錄的準確性,也有助於進一步分析資料。
邊境管理與安全
護照、身分證明文件與簽證上的機器可讀區(MRZ),可讓 OCR 系統在通關時自動讀取,加快處理速度並提升驗證準確度。
親自試用 OCR 技術
使用圖片轉文字工具,選取一張 JPG/JPEG、PNG、WebP、GIF、BMP 或 TIFF 圖片。送出前,請從 15 種辨識語言中選擇一種;一開始預選的是英文。辨識會在伺服器上執行。請將結果與圖片比對,再複製或下載純文字。工具不會翻譯,也不會重建文件版面。
本站不接受直接輸入 PDF。請先使用 PDF 轉圖片,再逐一辨識所需頁面的圖片。圖片限制為 20 MB、每一邊最多 8192 px,以及總像素數最多 2,500 萬。所有限制都必須同時符合。
OCR 與人工輸入資料的比較
OCR 與人工逐字輸入文件內容相比,有哪些差異?
| 項目 | OCR | 人工輸入資料 |
|---|---|---|
| 速度 | 每頁幾秒 | 每頁幾分鐘至數小時 |
| 成本 | 免費至低成本 | 按頁或按小時計算的人力成本 |
| 準確度 | 取決於圖片與辨識模型 | 取決於工作內容與校對 |
| 處理量 | 受檔案、處理資源與請求限制影響 | 受可用時間與人力限制 |
| 一致性 | 高 | 不一定(受疲勞、分心影響) |
| 可用時間 | 全天候 24/7 | 工作時間 |
大量文件處理時,OCR 在速度與成本上有明顯優勢。若文件數量少、內容十分複雜,且需要理解判斷而非單純轉錄,人工審閱仍很有價值。
OCR 的限制與挑戰
即使技術已有大幅進展,OCR 仍不完美。了解限制,有助於建立合理期待:
仰賴圖片品質
圖片品質不佳時,OCR 準確度會明顯下降。低解析度、模糊照片、光線不足與過度壓縮,都會影響結果。「輸入品質差,輸出也會差」尤其適用於這裡。
手寫風格差異
雖然現代 OCR 能處理許多手寫風格,個人書寫差異仍是挑戰。不尋常的字形、不一致的間距與高度風格化的書寫,都可能讓辨識演算法混淆。
複雜版面處理
多欄版面、表格、註腳與混合內容文件,需要進階的版面分析。當文字環繞圖片,或欄位分界不清楚時,OCR 可能難以正確處理。
語言與文字系統支援
主要拉丁字母語言通常有很好的 OCR 支援。較少見的語言、由右至左的文字系統(如阿拉伯文、希伯來文),以及複雜的字元集(如中文、日文、韓文),過去需要專門的 OCR 引擎;現代 AI 系統已大幅縮小這些差距。
數學公式與特殊符號
包含數學記號、化學公式或特殊符號集的技術文件,對未針對這些格式訓練的 OCR 系統而言,可能是一項挑戰。
OCR 技術的未來
AI 與深度學習整合
OCR 神經網路模型的能力逐年提升。現代系統達到的準確度,是傳統模式比對方法難以做到的。採用 Transformer 架構的趨勢,也就是大型語言模型背後的同類技術,正持續推升 OCR 的準確度。
手機即時 OCR
現代智慧型手機可直接在相機取景畫面中即時進行 OCR。Google Lens、Apple 的「原況文字」(Live Text)及類似功能,顯示 OCR 已快到足以處理行動裝置上的即時影像串流。
多模態文件理解
下一階段不只是辨識文字,而是理解文件的完整結構與意義,包括表格、圖表,以及文字與圖片之間的關係。結合視覺與語言理解的 AI 系統,在理解複雜文件方面正逐漸接近人類水準。
雲端 OCR 服務
主要雲端供應商提供的 API 型 OCR 服務,例如 Google Cloud Vision、AWS Textract 與 Azure Computer Vision,讓任何持有 API 金鑰的開發者都能使用企業級 OCR。這些服務在處理數十億份文件的過程中持續改善。
常見問題
OCR 的準確率是 100% 嗎?
辨識準確度取決於來源圖片、語言、字體樣式與版面。本站不承諾固定的準確率。請選取具有代表性的範例與原始內容比對,尤其要檢查姓名與數字;模型信心分數不是實際測量出的字元正確率。
OCR 可以辨識任何字型嗎?
大多數標準字型,例如 Times New Roman、Arial、Helvetica 等,都有很好的效果。高度裝飾、書寫體或特殊字型的辨識率可能較低。OCR 過去主要針對常見的商務與印刷字型進行最佳化。
OCR 能辨識手寫字嗎?
可以,但有限制。接近印刷體的手寫字(分開書寫的正楷字母),效果遠優於草寫。現代 AI OCR 已大幅改善手寫辨識,但準確度仍會因個人書寫風格而有很大差異。
OCR 與 PDF 文字擷取有什麼不同?
PDF 文字擷取會讀取以數位方式建立的 PDF 中,原本就內嵌的數位文字,例如將 Word 文件另存為 PDF。因為文字資料已經存在,所以不需要辨識。掃描文件、照片,以及由紙本掃描建立、文字只以像素存在的 PDF,才需要 OCR。
OCR 可以在同一份文件中辨識多種語言嗎?
部分 OCR 系統支援自動偵測,或同時使用多種辨識語言。本站需要手動從 15 種語言中選擇一種,不提供自動偵測或多種語言合併選取。請仔細檢查混合語言文字,或將適合的區域裁切後分別處理。
OCR 如何處理表格與結構化資料?
部分文件處理系統能重建表格。本工具只回傳純文字,因此可能失去欄位或儲存格邊界。請對照原始內容檢查閱讀順序與數字,必要時再使用合適的編輯器重建表格。
總結
OCR 已悄悄成為數位時代影響深遠的技術之一。它連結實體與數位世界,讓大量印刷及手寫資訊得以讀取、搜尋與處理。
從文件數位化到即時翻譯,從醫療紀錄到邊境安全,OCR 參與的日常生活面向,比多數人想像的更多。
請使用一張含有文字、格式受支援的 JPG、PNG、WebP、GIF、BMP 或 TIFF 圖片,試用我們的免費 OCR 工具。來源檔案不得超過 20 MB,每一邊不得超過 8,192 px,總像素數不得超過 2,500 萬;請選擇辨識語言,並檢查結果。