OCR : définition et fonctionnement de la reconnaissance de texte
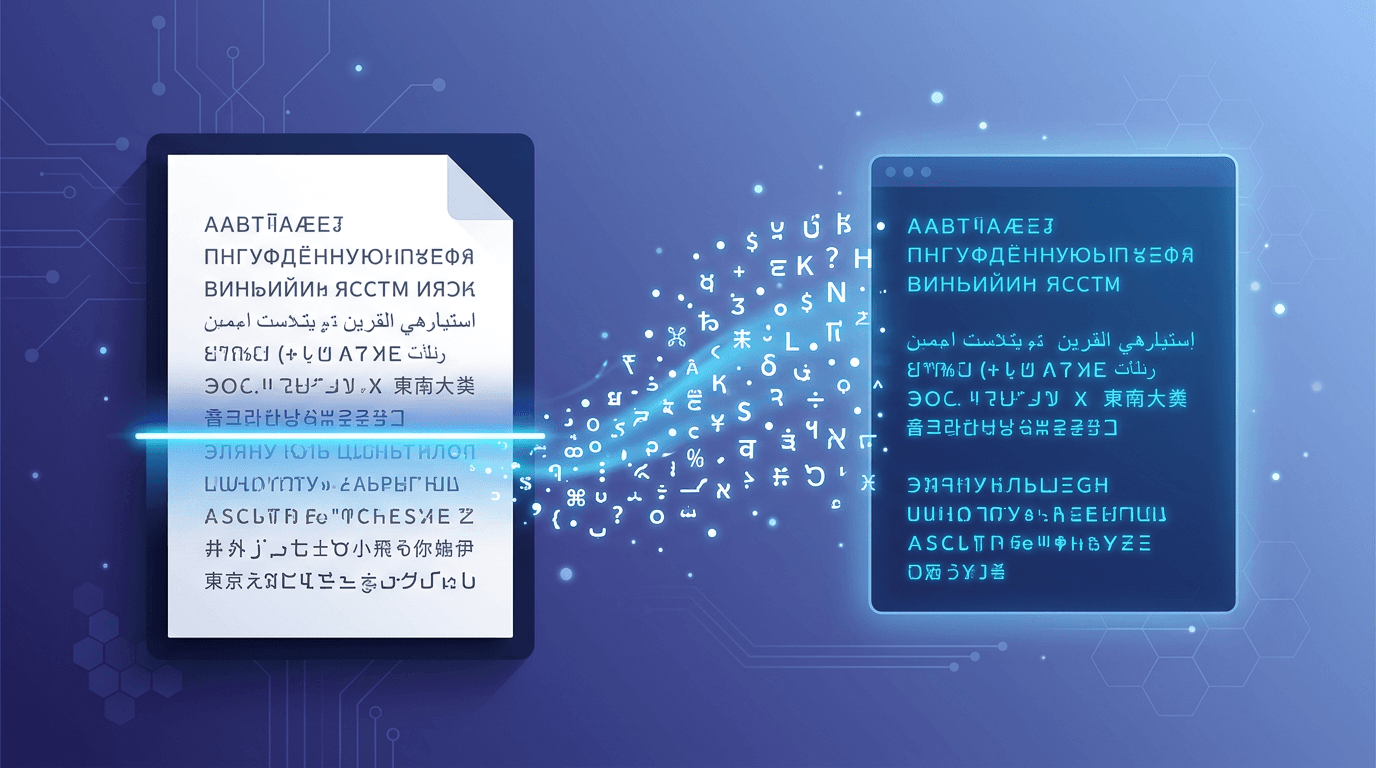
L’OCR, abréviation de l’anglais Optical Character Recognition, ou reconnaissance optique de caractères, est une technologie qui convertit les images contenant du texte en texte numérique exploitable par une machine. Ce guide vous explique son fonctionnement et pourquoi il est devenu essentiel dans notre monde numérique.
Les sections ci-dessous présentent la technologie OCR en général. La reconstitution de la mise en page, la traduction, la détection automatique de la langue et les modèles de reconnaissance de l’écriture manuscrite dépendent du produit utilisé. L’outil Image en texte de ce site extrait du texte brut à partir d’une seule image, avec une seule langue sélectionnée manuellement ; il ne propose pas ces fonctions plus avancées.
Qu’est-ce que l’OCR ?
L’OCR, ou reconnaissance optique de caractères, est une technologie qui :
- Reconnaît le texte dans les images, les documents numérisés et les photos
- Convertit le texte visible en un format numérique modifiable
- Permet la recherche dans des images dont le texte ne pouvait auparavant pas être recherché
- Automatise la saisie à partir de documents papier
Comment fonctionne la technologie OCR ?
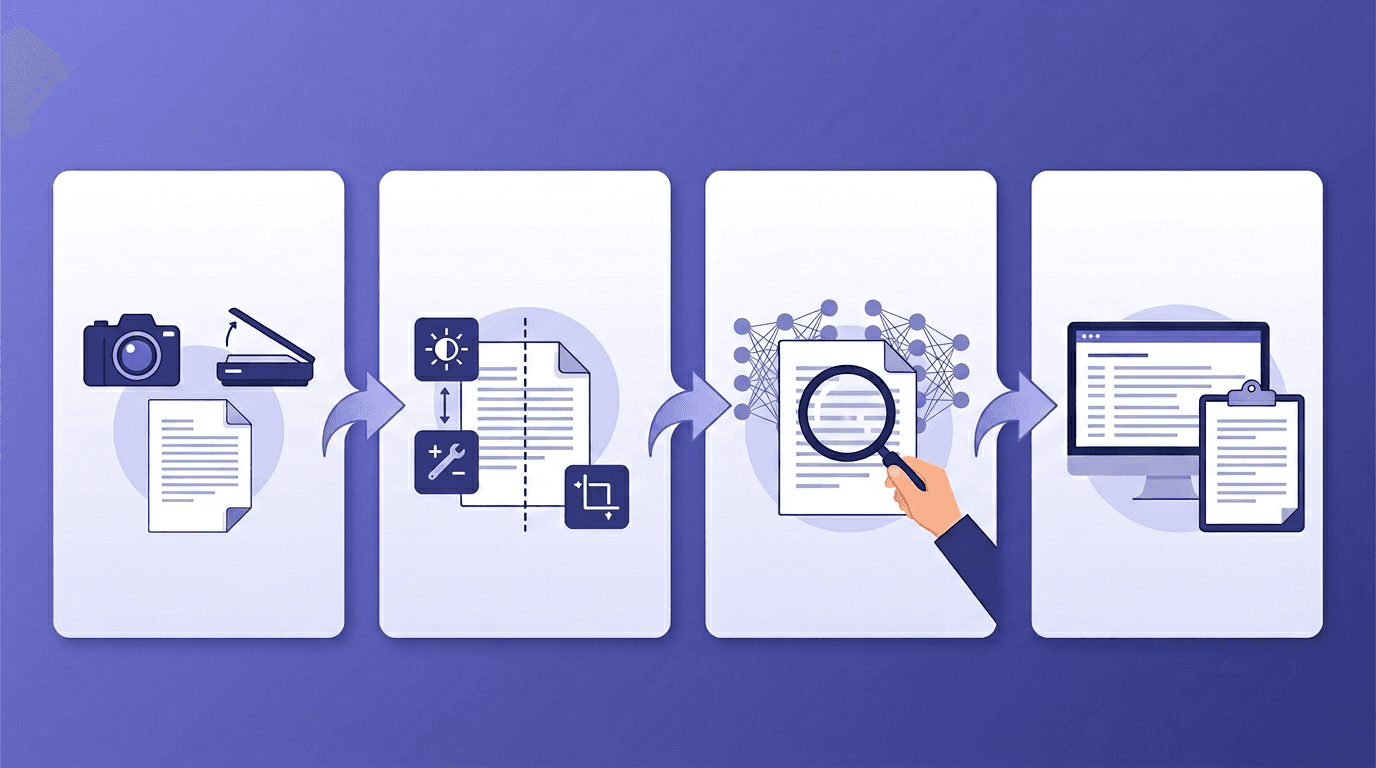
Étape 1 : acquisition de l’image
Le processus commence par la capture d’une image :
- Numérisation de documents papier
- Prise de photos avec un appareil photo
- Captures d’écran
- Importation d’images existantes
Étape 2 : prétraitement de l’image
L’image est préparée pour l’analyse :
- Binarisation - Conversion en noir et blanc
- Réduction du bruit - Suppression des taches et des artefacts
- Redressement - Correction de l’inclinaison du texte
- Analyse de la mise en page - Repérage des zones de texte
Étape 3 : reconnaissance des caractères
Des algorithmes identifient le texte :
- Comparaison de formes - Comparaison avec des formes de caractères connues
- Détection de caractéristiques - Repérage des particularités distinctives
- Apprentissage automatique - Réseaux de neurones entraînés sur des millions d’exemples
- Analyse du contexte - Utilisation des règles de la langue pour améliorer la précision
Étape 4 : post-traitement
Les résultats sont affinés :
- Vérification orthographique - Correction des erreurs évidentes
- Conservation de la mise en forme - Maintien de la structure
- Score de confiance - Indication du degré de certitude de la reconnaissance
Les différents types d’OCR
OCR classique
- Reconnaît le texte imprimé dans des polices classiques
- Fonctionne avec des images nettes et de bonne qualité
- Offre la meilleure précision sur les documents simples
Reconnaissance intelligente de caractères (ICR)
- Prend en charge le texte manuscrit
- Utilise l’apprentissage automatique pour s’adapter
- S’améliore avec l’entraînement
Reconnaissance intelligente de mots (IWR)
- Reconnaît les mots entiers
- Convient mieux à l’écriture cursive
- Tient compte du contexte
Reconnaissance optique de marques (OMR)
- Détecte les marques et les cases à cocher
- Sert aux enquêtes et aux tests
- Repose sur une détection binaire : marqué ou non marqué
Les facteurs de précision de l’OCR
| Facteur | Effet sur la précision |
|---|---|
| Qualité de l’image | Élevé |
| Type de police | Moyen à élevé |
| Contraste du texte | Élevé |
| État du document | Moyen |
| Complexité de la langue | Moyen |
| Texte manuscrit ou imprimé | Élevé |
Applications courantes de l’OCR
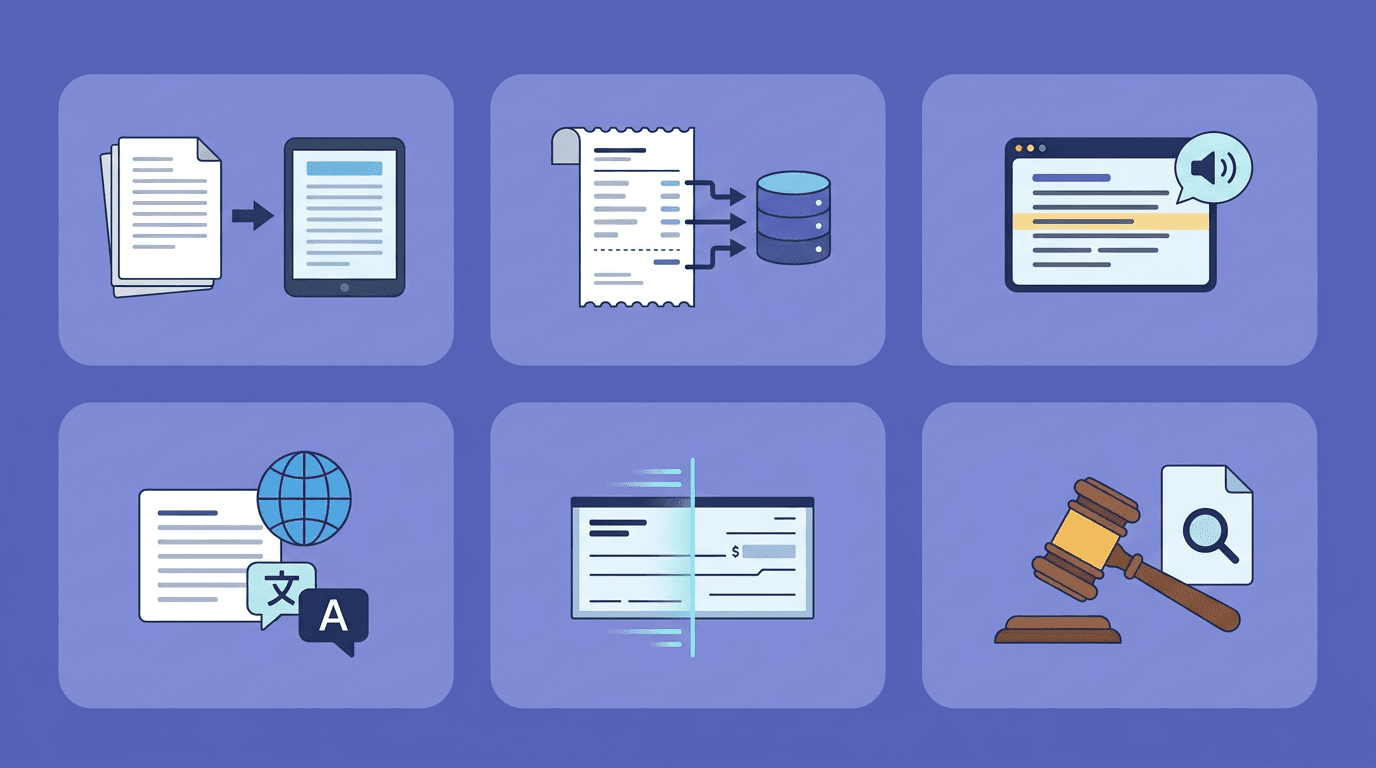
Numérisation de documents
Transformer des archives papier en fichiers numériques dans lesquels vous pouvez effectuer des recherches.
Automatisation de la saisie
Extraire des informations de formulaires, de factures et de reçus.
Accessibilité
Rendre les contenus imprimés accessibles aux lecteurs d’écran.
Traduction
Permettre l’extraction de texte pour les services de traduction.
Recherche documentaire juridique
Effectuer des recherches dans des documents juridiques numérisés.
Banque
Traiter des chèques et des documents financiers.
Essayez la technologie OCR
Utilisez Image en texte avec un seul fichier JPG/JPEG, PNG, WebP, GIF, BMP ou TIFF. Choisissez l’une des 15 langues de reconnaissance avant l’envoi ; l’anglais est sélectionné par défaut. La reconnaissance s’effectue sur le serveur. Comparez le résultat à l’image, puis copiez ou téléchargez le texte brut. L’outil ne traduit pas le texte et ne reconstitue pas la mise en page du document.
Les fichiers PDF ne sont pas acceptés directement ici. Utilisez d’abord PDF en images, puis traitez séparément les images des pages nécessaires. Les limites sont de 20 Mo par image, 8192 px par côté et 25 millions de pixels. Elles s’appliquent toutes simultanément.
OCR ou saisie manuelle ?
| Critère | OCR | Saisie manuelle |
|---|---|---|
| Rapidité | Secondes | Minutes ou heures |
| Coût | Gratuit à faible | Coût du travail |
| Précision | Dépend de l’image et du modèle de reconnaissance | Dépend de la tâche et de la relecture |
| Capacité | Limitée par les fichiers, les ressources de traitement et les limites de requêtes | Limitée par le temps et le personnel disponibles |
| Régularité | Élevée | Variable |
Les limites de l’OCR
Dépendance à la qualité
Une image de mauvaise qualité réduit fortement la précision.
Difficultés avec l’écriture manuscrite
La diversité des styles d’écriture manuscrite complique la reconnaissance.
Mises en page complexes
Les tableaux, les colonnes et les contenus mixtes peuvent perturber l’OCR.
Limites linguistiques
Certaines langues et certains systèmes d’écriture sont mieux pris en charge que d’autres.
L’avenir de l’OCR
Intégration de l’IA
L’apprentissage profond continue d’améliorer la précision et les capacités de reconnaissance.
Traitement en temps réel
Les appareils mobiles proposent désormais une reconnaissance OCR instantanée dans l’appareil photo.
Reconnaissance multimodale
Associer la compréhension des images, du texte et de la mise en page.
Traitement dans le cloud
Accéder à une reconnaissance OCR performante par des services web.
Questions fréquentes
L’OCR est-il précis à 100 % ?
La précision dépend de l’image source, de la langue, des caractères et de la mise en page. Aucun pourcentage fixe n’est garanti ici. Vérifiez un échantillon représentatif en le comparant à l’original, notamment les noms et les nombres ; le score de confiance d’un modèle n’est pas un taux mesuré de caractères correctement reconnus.
L’OCR peut-il lire toutes les polices ?
La plupart des polices classiques donnent de bons résultats. Les polices décoratives ou inhabituelles peuvent être moins bien reconnues.
L’OCR fonctionne-t-il avec l’écriture manuscrite ?
Oui, mais la précision varie fortement selon la lisibilité de l’écriture.
L’OCR est-il la même chose que l’extraction de texte ?
L’OCR reconnaît des caractères à partir de pixels. L’extraction de texte est plus large : elle peut aussi lire le texte déjà intégré à un PDF numérique, sans passer par la reconnaissance d’une image. Le formulaire OCR de ce site accepte des images ; convertissez d’abord toute page PDF numérisée en image.
L’OCR peut-il reconnaître plusieurs langues ?
Certains systèmes OCR proposent la détection automatique ou plusieurs langues de reconnaissance simultanées. Ici, vous devez choisir manuellement une seule des 15 langues ; la détection automatique et la sélection combinée de plusieurs langues ne sont pas proposées. Vérifiez soigneusement les textes multilingues ou traitez séparément des zones recadrées adaptées.
Conclusion
La technologie OCR a transformé notre manière d’utiliser les textes imprimés et manuscrits. Essayez notre outil OCR gratuit pour découvrir cette technologie par vous-même.
Outils associés : Image en texte | Convertisseur PDF | Outils pour documents
D’autres outils pour vos prochains travaux sur les images
Découvrez les outils ImgConvert pour la conversion, les fichiers PDF et les GIF.
- Convertisseurs d’images
- Outils PDF
- Outils GIF