Technologie OCR : comprendre la reconnaissance optique de caractères
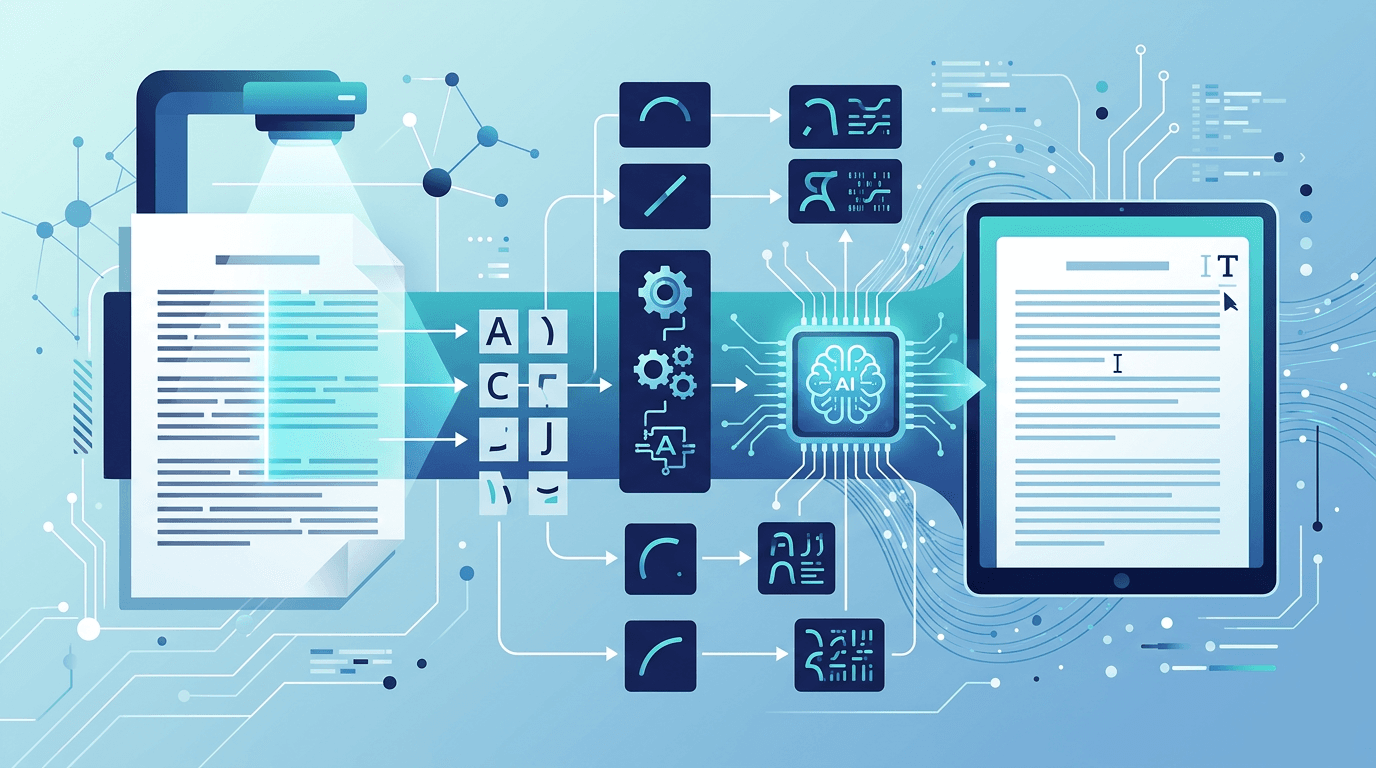
Chaque fois que vous photographiez un reçu et que ses montants sont automatiquement saisis dans une application de gestion des dépenses, ou que vous photographiez une carte de visite pour importer les coordonnées dans votre téléphone, vous utilisez l’OCR. La reconnaissance optique de caractères fait partie de ces technologies devenues discrètement indispensables : elle est partout, mais peu de gens savent vraiment comment elle fonctionne.
Ce guide explique ce qu’est l’OCR, la technologie sur laquelle il repose, ses domaines d’utilisation et ses limites.
Les sections ci-dessous présentent la technologie OCR en général. La reconstitution de la mise en page, la traduction, la détection automatique de la langue et les modèles de reconnaissance de l’écriture manuscrite dépendent du produit utilisé. L’outil Image en texte de ce site extrait du texte brut à partir d’une seule image, avec une seule langue sélectionnée manuellement ; il ne propose pas ces fonctions plus avancées.
Qu’est-ce que l’OCR ?
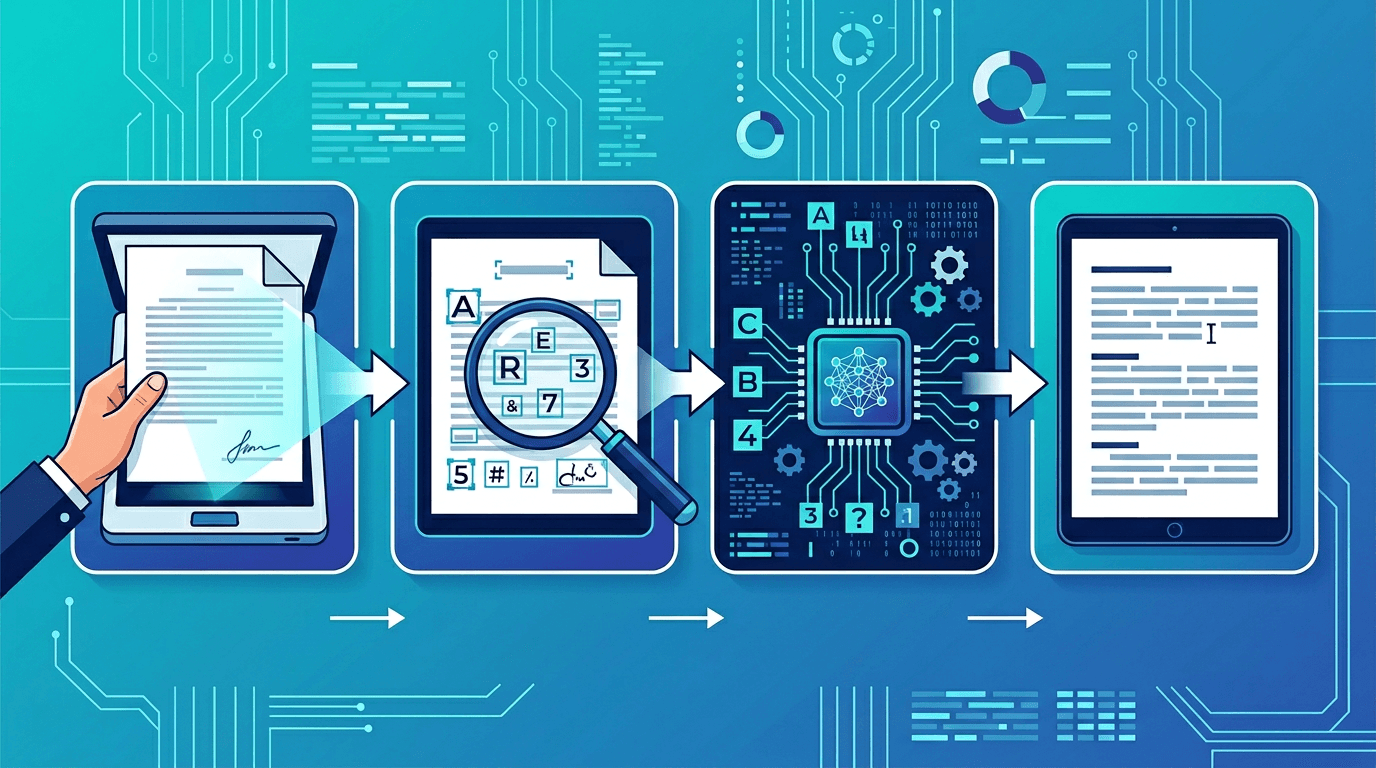
OCR est l’abréviation de Optical Character Recognition, soit « reconnaissance optique de caractères ». Cette technologie permet aux ordinateurs d’identifier et d’extraire du texte à partir d’images, de documents numérisés et de photographies, pour le convertir en texte numérique exploitable par une machine.
L’OCR remplit essentiellement quatre fonctions :
- Reconnaître le texte — dans les images, les documents numérisés et les photos
- Convertir le texte visible — en un format numérique modifiable dans lequel vous pouvez effectuer des recherches
- Permettre la recherche — dans des contenus sous forme d’images qui ne pouvaient auparavant pas être recherchés
- Automatiser la saisie — en extrayant des informations de documents papier
Avant l’OCR, une photographie de document restait une simple photographie : pour l’ordinateur, le texte qu’elle contenait n’était pas exploitable en tant que tel. L’OCR fait le lien entre le monde physique du texte imprimé et celui des données numériques que vous pouvez rechercher et traiter.
Comment fonctionne la technologie OCR ?
L’OCR moderne repose sur une succession de traitements élaborés. Comprendre ces étapes permet de mieux saisir pourquoi il est si précis dans de bonnes conditions et pourquoi certaines situations lui posent problème.
Étape 1 : acquisition de l’image
Le processus commence par la capture ou l’importation d’une image :
- Numériser un document papier avec un scanner à plat ou un scanner de documents
- Photographier du texte avec l’appareil photo d’un smartphone
- Faire une capture d’écran
- Importer un fichier existant (JPG, PNG, PDF, TIFF, etc.)
La qualité à cette étape est déterminante : elle fixe les possibilités de tous les traitements suivants. Une photo floue ou mal éclairée donnera de moins bons résultats qu’une numérisation nette en haute résolution.
Étape 2 : prétraitement de l’image
Avant la reconnaissance des caractères, l’image subit plusieurs opérations d’amélioration :
- Binarisation : convertit l’image en noir et blanc purs. Les informations de couleur sont supprimées pour simplifier l’image et mieux distinguer le texte de l’arrière-plan.
- Réduction du bruit : élimine les taches, le grain et les artefacts qui pourraient être confondus avec des caractères.
- Redressement : corrige l’inclinaison ou la rotation du document. Si vous photographiez une page légèrement de travers, cette étape la remet droite.
- Suppression des points parasites : retire les petits points dispersés aléatoirement dans l’image.
- Analyse de la mise en page : repère et sépare les différentes zones — texte principal, en-têtes, encadrés latéraux, tableaux, images — afin de traiter chacune de manière adaptée.
Étape 3 : reconnaissance des caractères
C’est à cette étape que le texte est réellement identifié. Les moteurs OCR modernes combinent plusieurs approches :
Comparaison de formes : compare chaque caractère à une bibliothèque de formes connues. Cette méthode est efficace pour les polices classiques aux caractères bien définis.
Détection de caractéristiques : analyse les particularités de chaque caractère, comme les courbes, les intersections et les espaces fermés. Par exemple, la lettre « B » possède deux boucles fermées à droite, contre une seule pour le « P ». Ces caractéristiques structurelles permettent de reconnaître les caractères même lorsque leur forme exacte varie.
Réseaux de neurones : les moteurs OCR modernes utilisent des modèles d’apprentissage profond entraînés sur des millions d’exemples de texte. Ces modèles ont appris à reconnaître les caractères dans une très grande variété de polices, de tailles, de styles d’écriture manuscrite et de conditions d’image.
Analyse du contexte : une fois les caractères identifiés, l’analyse linguistique améliore les résultats. Si la reconnaissance a produit « h0use » au lieu de « house », le modèle de langue déduit que le « 0 » est probablement un « o » dans ce contexte, en s’appuyant sur les mots voisins et les régularités de la langue.
Étape 4 : post-traitement
La dernière étape affine les résultats et prépare leur restitution :
- Vérification orthographique : signale et corrige les erreurs évidentes à l’aide d’un dictionnaire
- Conservation de la mise en page : maintient la structure du document d’origine, notamment les colonnes, les tableaux et les sauts de paragraphe
- Score de confiance : attribue un pourcentage de confiance à chaque caractère ou mot reconnu, afin que les applications puissent signaler les résultats incertains pour une vérification humaine
- Format de sortie : exporte le résultat dans le format souhaité : texte brut, PDF avec recherche textuelle, document Word ou données structurées
Les différents types de technologie OCR
OCR classique
La forme d’origine, qui reste la plus courante :
- Reconnaît le texte imprimé dans des polices classiques
- Donne les meilleurs résultats avec des images nettes, de bonne qualité et bien éclairées
- Offre la meilleure précision pour le traitement de documents formels
- Fonctionne avec la grande majorité des documents imprimés
Reconnaissance intelligente de caractères (ICR)
Une évolution conçue spécifiquement pour le texte manuscrit :
- Utilise des techniques avancées d’apprentissage automatique pour traiter divers styles d’écriture
- S’améliore continuellement à mesure qu’elle est exposée à de nouveaux exemples
- Reste moins précise que l’OCR classique appliqué au texte imprimé
- Sert au traitement des chèques bancaires, à la numérisation de documents historiques et au traitement de formulaires
Reconnaissance intelligente de mots (IWR)
Cette approche reconnaît les mots dans leur ensemble plutôt que caractère par caractère :
- Est plus efficace pour l’écriture cursive et les lettres liées, dont les formes se rejoignent
- Améliore la précision grâce à un traitement tenant compte du contexte
- S’associe à des modèles de langue pour produire un texte naturel
- Sert au tri du courrier et à la numérisation de formulaires
Reconnaissance optique de marques (OMR)
Une variante spécialisée qui détecte des marques au lieu de lire du texte :
- Repère les cases à cocher, les bulles et les marques, remplies ou vides
- Sert aux tests standardisés, aux enquêtes et à la numérisation de bulletins de vote
- Repose sur une détection binaire : marqué ou non marqué
- Offre une très grande précision lorsque l’image est de bonne qualité
Lecture de codes-barres et de QR codes
Ces technologies proches, mais techniquement distinctes de l’OCR appliqué au texte :
- Lisent les codes-barres 1D et 2D
- Décodent les QR codes
- Extraient des données encodées plutôt que du texte visible
- Sont intégrées à de nombreuses applications dotées de fonctions OCR
Les facteurs qui influencent la précision de l’OCR
Comprendre ce qui favorise ou gêne la reconnaissance vous aide à obtenir de meilleurs résultats :
| Facteur | Effet sur la précision | Remarques |
|---|---|---|
| Résolution de l’image | Élevé | Il faut assez de pixels pour distinguer chaque caractère ; une simple indication de DPI ne suffit pas |
| Netteté de l’image | Très élevé | Le flou est la principale cause de perte de qualité |
| Contraste du texte | Élevé | L’idéal est un texte foncé sur un fond clair |
| Type de police | Moyen à élevé | Polices classiques > polices décoratives |
| État du document | Moyen | Les plis, les taches et les dégradations réduisent la précision |
| Complexité de la langue | Moyen | Les écritures latines sont plus faciles à reconnaître que les systèmes d’écriture complexes |
| Écriture manuscrite | Élevé | Les variations individuelles compliquent la reconnaissance |
| Éclairage | Élevé | Un éclairage irrégulier crée des ombres et des artefacts |
Applications concrètes de l’OCR
L’OCR ne se limite pas à un seul usage : cette technologie sert de base à des dizaines d’applications dans de nombreux secteurs.
Numérisation de documents
Les bibliothèques, les cabinets d’avocats, les administrations et les entreprises utilisent l’OCR pour transformer des décennies d’archives papier en archives numériques interrogeables. Un document qu’il fallait autrefois retrouver à la main dans des classeurs peut ainsi être localisé en quelques secondes grâce à une recherche dans le texte intégral.
Saisie automatisée de données
Au lieu de saisir manuellement dans une base de données les informations figurant sur des factures, des bons de commande ou des formulaires, l’OCR les extrait automatiquement. Cette approche est largement utilisée en comptabilité fournisseurs, dans le traitement des déclarations de sinistre et dans la gestion des dossiers médicaux.
Accessibilité
L’OCR peut fournir du texte lisible par les technologies d’assistance. Un PDF accessible doit également avoir un ordre de lecture et une structure corrects ; la technique OCR du W3C prévoit ces vérifications. Ce site exporte du texte brut, pas un PDF balisé.
Services de traduction
Les applications de traduction utilisent l’OCR pour extraire le texte d’une image avant de le traduire. Lorsque vous pointez votre appareil photo vers un menu en langue étrangère, l’OCR récupère le texte pour permettre sa traduction immédiate.
Recherche documentaire juridique
Dans le cadre d’un litige, les équipes juridiques doivent parcourir des milliers de documents. L’OCR convertit les documents numérisés en texte interrogeable, ce qui permet de rechercher des termes ou des expressions dans l’ensemble d’un dossier documentaire.
Services financiers
L’OCR peut aider à extraire des numéros de compte ou des montants imprimés à partir d’images de documents. Reconnaître des caractères ne permet ni de vérifier une signature ni d’établir l’authenticité d’un document ; ces contrôles nécessitent un processus distinct. Ce site propose uniquement l’extraction de texte.
Santé
La gestion des dossiers médicaux s’appuie de plus en plus sur l’OCR pour convertir des notes manuscrites, des résultats d’analyses et des ordonnances en dossiers électroniques structurés. Cela améliore la précision de la tenue des dossiers et facilite l’analyse des données.
Contrôle aux frontières et sécurité
Les passeports, les pièces d’identité et les visas comportent des zones de lecture automatique (MRZ) que les systèmes OCR lisent aux frontières, afin d’accélérer les contrôles et d’améliorer la précision des vérifications.
Essayez vous-même la technologie OCR
Utilisez Image en texte avec un seul fichier JPG/JPEG, PNG, WebP, GIF, BMP ou TIFF. Choisissez l’une des 15 langues de reconnaissance avant l’envoi ; l’anglais est sélectionné par défaut. La reconnaissance s’effectue sur le serveur. Comparez le résultat à l’image, puis copiez ou téléchargez le texte brut. L’outil ne traduit pas le texte et ne reconstitue pas la mise en page du document.
Les fichiers PDF ne sont pas acceptés directement ici. Utilisez d’abord PDF en images, puis traitez séparément les images des pages nécessaires. Les limites sont de 20 Mo par image, 8192 px par côté et 25 millions de pixels. Elles s’appliquent toutes simultanément.
OCR ou saisie manuelle ?
Comment l’OCR se compare-t-il à la transcription manuelle du contenu d’un document ?
| Critère | OCR | Saisie manuelle |
|---|---|---|
| Rapidité | Quelques secondes par page | De quelques minutes à plusieurs heures par page |
| Coût | Gratuit à faible | Coût du travail par page ou par heure |
| Précision | Dépend de l’image et du modèle de reconnaissance | Dépend de la tâche et de la relecture |
| Capacité | Limitée par les fichiers, les ressources de traitement et les limites de requêtes | Limitée par le temps et le personnel disponibles |
| Régularité | Élevée | Variable selon la fatigue et les distractions |
| Disponibilité | 24 h/24, 7 j/7 | Heures de travail |
Pour traiter de gros volumes de documents, l’OCR présente un net avantage en matière de rapidité et de coût. Pour de petits volumes de documents très complexes, qui nécessitent une interprétation plutôt qu’une simple transcription, la vérification humaine reste précieuse.
Limites et difficultés de l’OCR
Malgré des progrès importants, l’OCR n’est pas parfait. Connaître ses limites permet de garder des attentes réalistes :
Dépendance à la qualité de l’image
La précision de l’OCR chute fortement lorsque l’image est de mauvaise qualité. Une faible résolution, le flou, un mauvais éclairage ou une compression importante affectent tous les résultats. Le principe est simple : une source de mauvaise qualité donne de mauvais résultats.
Variabilité de l’écriture manuscrite
Même si l’OCR moderne prend en charge de nombreux styles d’écriture manuscrite, les variations individuelles restent difficiles à traiter. Des lettres aux formes inhabituelles, des espacements irréguliers et une écriture très stylisée peuvent perturber les algorithmes de reconnaissance.
Traitement des mises en page complexes
Les mises en page à plusieurs colonnes, les tableaux, les notes de bas de page et les documents aux contenus variés nécessitent une analyse élaborée. L’OCR peut rencontrer des difficultés lorsque le texte entoure des images ou que les colonnes sont mal délimitées.
Prise en charge des langues et des systèmes d’écriture
Les principales langues à alphabet latin bénéficient généralement d’une excellente prise en charge OCR. Les langues moins courantes, les écritures de droite à gauche comme l’arabe ou l’hébreu, et les systèmes de caractères complexes comme le chinois, le japonais ou le coréen ont longtemps nécessité des moteurs spécialisés. Les systèmes modernes fondés sur l’IA ont toutefois fortement réduit cet écart.
Formules mathématiques et symboles particuliers
Les documents techniques contenant des notations mathématiques, des formules chimiques ou des ensembles de symboles inhabituels peuvent poser problème aux systèmes OCR qui n’ont pas été spécifiquement entraînés à les reconnaître.
L’avenir de la technologie OCR
Intégration de l’IA et de l’apprentissage profond
Chaque année, les modèles de réseaux de neurones destinés à l’OCR gagnent en capacité. Les systèmes modernes atteignent des niveaux de précision impossibles avec les méthodes traditionnelles de comparaison de formes. Le recours croissant aux architectures Transformer, également utilisées dans les grands modèles de langage, améliore encore la précision de l’OCR.
OCR mobile en temps réel
Les smartphones modernes peuvent effectuer une reconnaissance OCR en temps réel, directement dans le viseur de l’appareil photo. Google Lens, Texte en direct d’Apple et d’autres fonctions similaires montrent que l’OCR est désormais assez rapide pour traiter un flux vidéo en direct sur un appareil mobile.
Compréhension multimodale des documents
La prochaine étape ne consiste plus seulement à reconnaître le texte, mais à comprendre toute la structure et le sens d’un document : tableaux, graphiques et relations entre le texte et les images. Les systèmes d’IA qui associent compréhension visuelle et compréhension du langage se rapprochent des capacités humaines d’interprétation de documents complexes.
Services OCR dans le cloud
Les services OCR accessibles par API des grands fournisseurs cloud, comme Google Cloud Vision, AWS Textract et Azure Computer Vision, mettent une reconnaissance de niveau professionnel à la portée de tout développeur disposant d’une clé API. Ces services continuent de s’améliorer à mesure qu’ils traitent des milliards de documents.
Questions fréquentes
L’OCR est-il précis à 100 % ?
La précision dépend de l’image source, de la langue, des caractères et de la mise en page. Aucun pourcentage fixe n’est garanti ici. Vérifiez un échantillon représentatif en le comparant à l’original, notamment les noms et les nombres ; le score de confiance d’un modèle n’est pas un taux mesuré de caractères correctement reconnus.
L’OCR peut-il reconnaître toutes les polices ?
La plupart des polices classiques, comme Times New Roman, Arial ou Helvetica, donnent d’excellents résultats. Les polices très décoratives, cursives ou inhabituelles peuvent être moins bien reconnues. L’OCR a historiquement été optimisé pour les polices courantes des documents professionnels et imprimés.
L’OCR fonctionne-t-il avec l’écriture manuscrite ?
Oui, avec certaines limites. Les lettres manuscrites détachées, proches des caractères d’imprimerie, sont bien mieux reconnues que l’écriture cursive. L’OCR moderne fondé sur l’IA a fortement amélioré la reconnaissance de l’écriture manuscrite, mais la précision varie beaucoup selon le style de chaque personne.
Quelle différence entre l’OCR et l’extraction de texte d’un PDF ?
L’extraction de texte d’un PDF lit le texte numérique intégré aux fichiers créés directement au format numérique, par exemple un document Word enregistré en PDF. Aucune reconnaissance n’est nécessaire, puisque le texte est déjà présent sous forme de données. L’OCR est nécessaire pour les documents numérisés, les photos et les PDF issus de la numérisation de documents papier, dans lesquels le texte n’existe que sous forme de pixels.
L’OCR peut-il reconnaître plusieurs langues dans un même document ?
Certains systèmes OCR proposent la détection automatique ou plusieurs langues de reconnaissance simultanées. Ici, vous devez choisir manuellement une seule des 15 langues ; la détection automatique et la sélection combinée de plusieurs langues ne sont pas proposées. Vérifiez soigneusement les textes multilingues ou traitez séparément des zones recadrées adaptées.
Comment l’OCR traite-t-il les tableaux et les données structurées ?
Certains systèmes de traitement documentaire reconstituent les tableaux. Cet outil renvoie du texte brut : les colonnes ou les limites des cellules peuvent donc être perdues. Comparez l’ordre de lecture et les nombres à l’original, puis reconstituez le tableau dans un éditeur adapté si nécessaire.
En résumé
L’OCR est devenu, sans faire de bruit, l’une des technologies les plus importantes de l’ère numérique. Il relie les mondes physique et numérique en rendant l’immense quantité d’informations imprimées ou manuscrites accessible, interrogeable et exploitable.
De la numérisation de documents à la traduction en temps réel, des dossiers médicaux à la sécurité aux frontières, l’OCR intervient dans davantage d’aspects du quotidien qu’on ne l’imagine.
Essayez notre outil OCR gratuit : importez une image contenant du texte pour découvrir cette technologie en action.
Outils associés : Image en texte | PDF en images | Image en PDF
D’autres outils pour vos prochains travaux sur les images
Découvrez les outils ImgConvert pour la conversion, les fichiers PDF et les GIF.
- Convertisseurs d’images
- Outils PDF
- Outils GIF