Công nghệ OCR là gì? Hướng dẫn đầy đủ về nhận dạng ký tự quang học
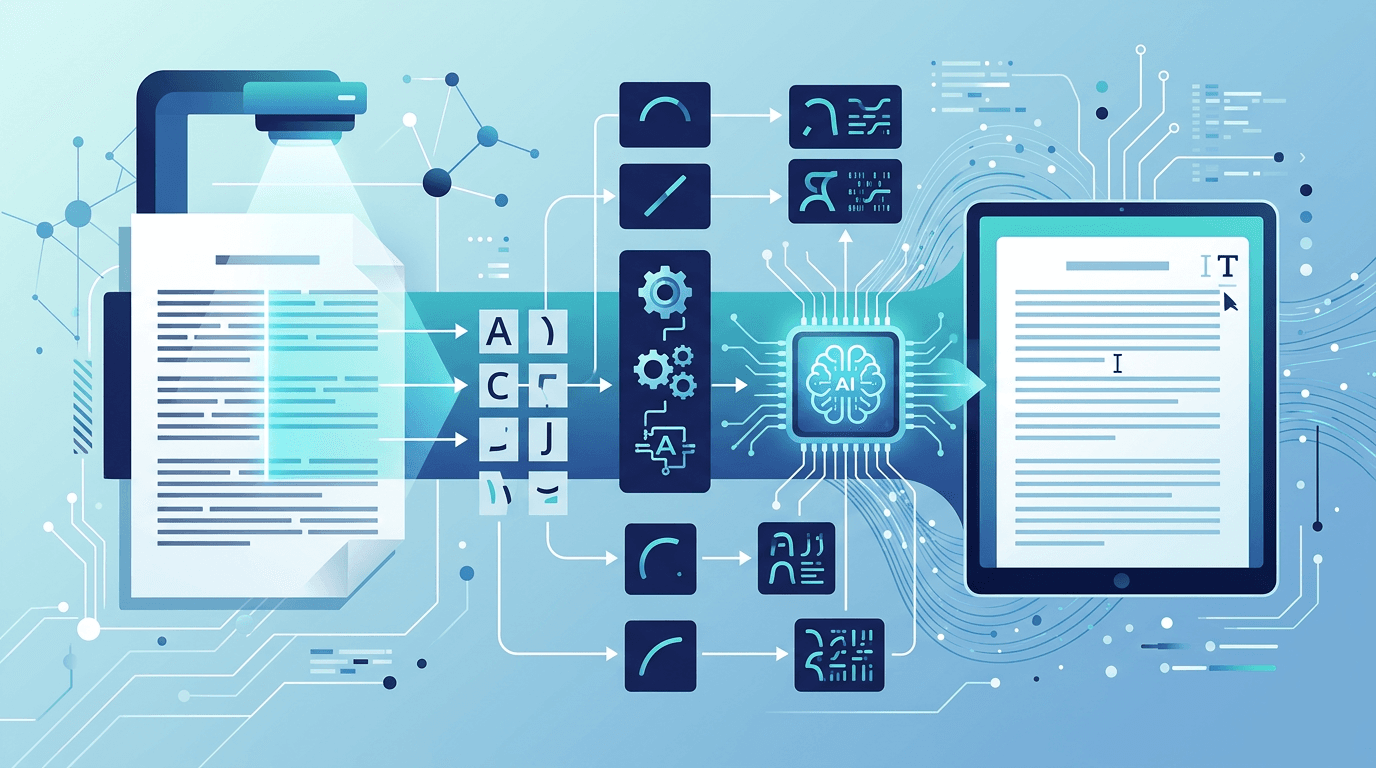
Mỗi khi chụp ảnh hóa đơn để số tiền tự động được nhập vào ứng dụng quản lý chi tiêu, hoặc chụp danh thiếp để thông tin liên hệ được lưu vào điện thoại, bạn đang sử dụng OCR. Nhận dạng ký tự quang học (Optical Character Recognition) là một trong những công nghệ âm thầm trở nên không thể thiếu — xuất hiện ở khắp nơi nhưng phần lớn mọi người chưa hiểu rõ cách hoạt động.
Bài hướng dẫn này giải thích OCR là gì, công nghệ phía sau, nơi ứng dụng và các giới hạn.
Các phần dưới đây giải thích về công nghệ OCR nói chung. Những tính năng như dựng lại bố cục, dịch, tự động phát hiện ngôn ngữ và mô hình nhận dạng chữ viết tay khác nhau tùy sản phẩm. Công cụ chuyển ảnh thành văn bản của trang web này trích xuất văn bản thuần từ một ảnh với một ngôn ngữ được chọn thủ công; công cụ không cung cấp các tính năng mở rộng đó.
OCR là gì?
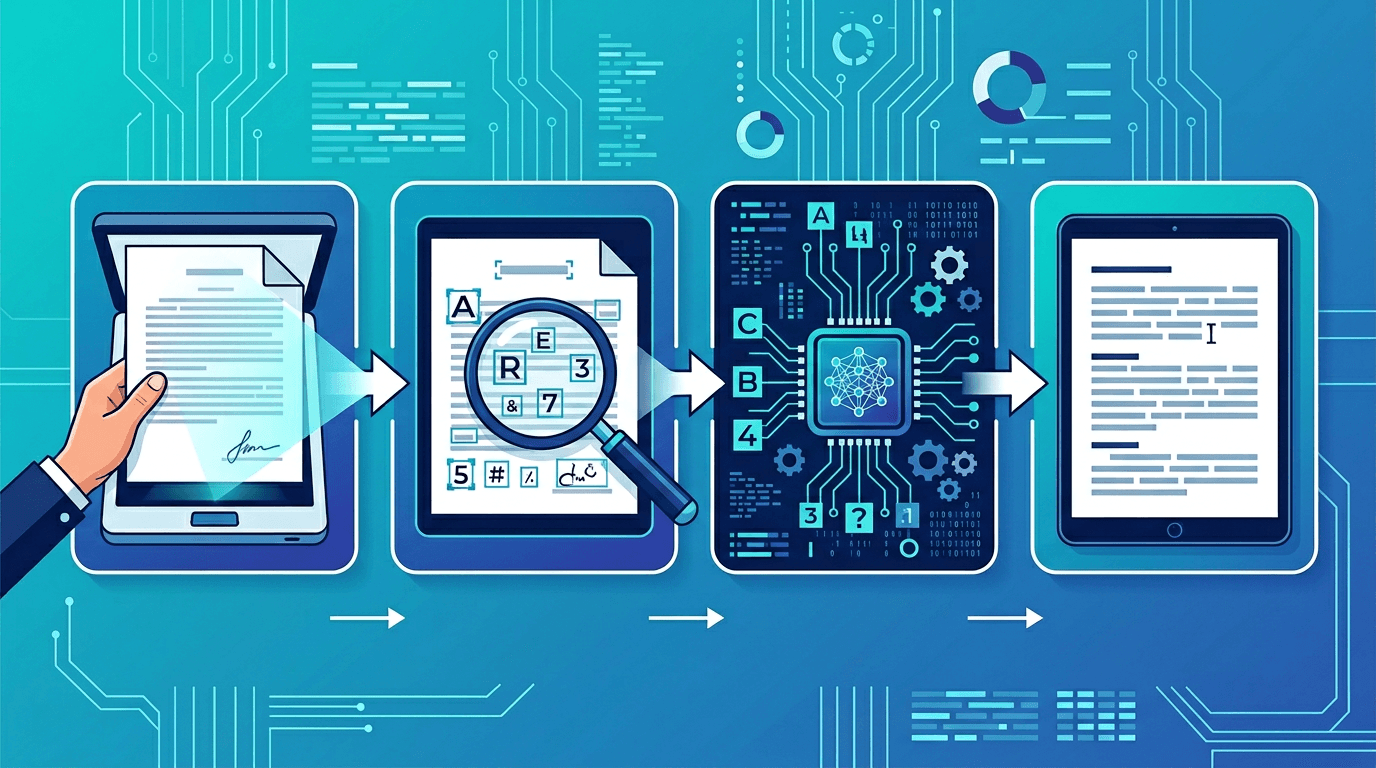
OCR là viết tắt của Optical Character Recognition, nghĩa là nhận dạng ký tự quang học. Công nghệ này giúp máy tính nhận biết và trích xuất chữ từ hình ảnh, tài liệu đã quét và ảnh chụp, chuyển chữ nhìn thấy trong ảnh thành văn bản số mà máy có thể đọc.
Về cốt lõi, OCR thực hiện bốn việc:
- Nhận dạng văn bản — trong hình ảnh, tài liệu đã quét và ảnh chụp
- Chuyển chữ trong ảnh — thành định dạng số có thể chỉnh sửa và tìm kiếm
- Cho phép tìm kiếm — trong nội dung dạng ảnh trước đây chưa thể tìm kiếm
- Tự động hóa nhập liệu — trích xuất thông tin từ tài liệu giấy
Trước khi có OCR, ảnh chụp tài liệu chỉ là một bức ảnh — với máy tính, chữ trong đó gần như không tồn tại dưới dạng văn bản. OCR kết nối thế giới vật lý của chữ in với thế giới số của dữ liệu có thể tìm kiếm và xử lý.
Công nghệ OCR hoạt động như thế nào
OCR hiện đại gồm một chuỗi xử lý phức tạp. Hiểu các giai đoạn này giúp lý giải vì sao OCR rất chính xác trong điều kiện tốt nhưng gặp khó khăn trong điều kiện bất lợi.
Giai đoạn 1: Thu nhận hình ảnh
Quy trình bắt đầu bằng việc chụp hoặc nhập ảnh:
- Quét tài liệu giấy bằng máy quét phẳng hoặc máy quét tài liệu
- Chụp chữ bằng camera điện thoại thông minh
- Chụp màn hình nội dung đang hiển thị
- Nhập tệp có sẵn (JPG, PNG, PDF, TIFF, v.v.)
Chất lượng ở giai đoạn này rất quan trọng — nó đặt ra giới hạn cho mọi bước tiếp theo. Ảnh mờ hoặc thiếu sáng sẽ cho kết quả kém hơn bản quét sạch, có độ phân giải cao.
Giai đoạn 2: Tiền xử lý ảnh
Trước khi bắt đầu nhận dạng ký tự, ảnh trải qua một số thao tác cải thiện:
- Nhị phân hóa: Chuyển ảnh thành hai màu đen và trắng thuần. Thao tác này loại bỏ thông tin màu, đơn giản hóa ảnh và giúp phân biệt chữ với nền dễ hơn.
- Giảm nhiễu: Loại bỏ đốm, hạt và các lỗi hình ảnh có thể bị nhầm thành ký tự.
- Chỉnh độ nghiêng: Căn lại tài liệu bị nghiêng hoặc xoay. Nếu chụp trang giấy hơi lệch góc, bước này sẽ làm thẳng ảnh.
- Loại bỏ đốm nhiễu: Xóa các chấm nhỏ xuất hiện ngẫu nhiên trong ảnh.
- Phân tích bố cục: Nhận biết và tách các vùng khác nhau — nội dung chính, đầu trang, cột bên, bảng, hình ảnh — để xử lý từng vùng phù hợp.
Giai đoạn 3: Nhận dạng ký tự
Đây là bước thực sự nhận biết văn bản. Các bộ máy OCR hiện đại dùng đồng thời nhiều phương pháp:
Đối sánh mẫu: So sánh từng ký tự với thư viện hình dạng ký tự đã biết. Cách này hiệu quả với phông chữ thông dụng, có hình dạng rõ ràng.
Phát hiện đặc trưng: Phân tích đặc điểm cấu trúc riêng của từng ký tự — đường cong, giao điểm, vùng khép kín. Ví dụ, chữ "B" có hai vòng khép kín bên phải, còn chữ "P" có một. Các đặc điểm này cho phép nhận dạng ký tự ngay cả khi hình dạng cụ thể thay đổi.
Mạng nơ-ron: Các bộ máy OCR hiện đại dùng mô hình học sâu được huấn luyện trên hàng triệu mẫu văn bản. Những mô hình này đã học cách nhận dạng ký tự với rất nhiều phông chữ, kích thước, kiểu viết tay và điều kiện ảnh khác nhau.
Phân tích ngữ cảnh: Sau khi nhận dạng từng ký tự, phân tích ngôn ngữ giúp cải thiện kết quả. Nếu bước nhận dạng đọc thành "h0use" thay vì "house", mô hình ngôn ngữ xác định rằng "0" trong ngữ cảnh này có nhiều khả năng là "o", dựa vào từ xung quanh và quy luật ngôn ngữ.
Giai đoạn 4: Hậu xử lý
Giai đoạn cuối tinh chỉnh và chuẩn bị đầu ra:
- Kiểm tra chính tả: Đánh dấu và sửa lỗi rõ ràng bằng cách tra từ điển
- Giữ bố cục: Duy trì cấu trúc định dạng của tài liệu gốc (cột, bảng, ngắt đoạn)
- Chấm điểm độ tin cậy: Gán tỷ lệ độ tin cậy cho từng ký tự hoặc từ đã nhận dạng, giúp ứng dụng đánh dấu kết quả có độ tin cậy thấp để con người kiểm tra
- Định dạng đầu ra: Xuất kết quả ở định dạng mong muốn (văn bản thuần, PDF có thể tìm kiếm, tài liệu Word, dữ liệu có cấu trúc)
Các loại công nghệ OCR
OCR thông thường
Loại ban đầu và phổ biến nhất:
- Nhận dạng chữ in bằng phông chữ thông dụng
- Hiệu quả nhất với ảnh sạch, chất lượng cao và đủ sáng
- Chính xác nhất khi xử lý tài liệu chính quy
- Hoạt động với phần lớn tài liệu in
Nhận dạng ký tự thông minh (ICR)
Một bước phát triển được thiết kế riêng cho chữ viết tay:
- Dùng học máy nâng cao để xử lý nhiều kiểu chữ viết tay
- Liên tục cải thiện khi tiếp xúc với thêm ví dụ
- Vẫn kém chính xác hơn OCR thông thường đối với chữ in
- Dùng trong xử lý séc ngân hàng, số hóa tài liệu lịch sử và xử lý biểu mẫu
Nhận dạng từ thông minh (IWR)
Nhận dạng toàn bộ từ thay vì từng ký tự riêng lẻ:
- Hiệu quả hơn với chữ viết tay liền nét, nơi các ký tự nối vào nhau
- Xử lý theo ngữ cảnh giúp cải thiện độ chính xác
- Kết hợp với mô hình ngôn ngữ để tạo văn bản tự nhiên
- Dùng trong phân loại thư bưu chính và số hóa biểu mẫu
Nhận dạng dấu quang học (OMR)
Một dạng chuyên biệt để phát hiện dấu đánh thay vì đọc chữ:
- Nhận biết ô chọn, ô tròn và dấu đánh (đã tô hoặc để trống)
- Dùng trong bài thi chuẩn hóa, khảo sát và quét phiếu bầu
- Phát hiện nhị phân: đã đánh dấu hoặc chưa đánh dấu
- Độ chính xác rất cao khi ảnh có chất lượng tốt
Nhận dạng mã vạch và mã QR
Dù về kỹ thuật khác với OCR văn bản, các công nghệ liên quan này:
- Đọc mã vạch 1D và 2D
- Giải mã mã QR
- Trích xuất dữ liệu đã mã hóa thay vì chữ nhìn thấy trong ảnh
- Được tích hợp vào nhiều ứng dụng có khả năng OCR
Các yếu tố ảnh hưởng đến độ chính xác của OCR
Hiểu điều gì giúp OCR hoạt động tốt hoặc khiến kết quả kém sẽ giúp cải thiện kết quả:
| Yếu tố | Ảnh hưởng đến độ chính xác | Ghi chú |
|---|---|---|
| Độ phân giải ảnh | Cao | Cần đủ pixel để phân biệt từng ký tự; chỉ có thông tin DPI là chưa đủ |
| Độ sắc nét của ảnh | Rất cao | Ảnh mờ là yếu tố làm giảm chất lượng nhiều nhất |
| Độ tương phản của chữ | Cao | Chữ tối trên nền sáng là lý tưởng |
| Loại phông chữ | Trung bình đến cao | Phông thông dụng > phông trang trí |
| Tình trạng tài liệu | Trung bình | Nếp gấp, vết bẩn và hư hỏng làm giảm độ chính xác |
| Độ phức tạp của ngôn ngữ | Trung bình | Hệ chữ Latin dễ nhận dạng hơn các hệ chữ phức tạp |
| Chữ viết tay | Cao | Khác biệt giữa mỗi người gây khó khăn |
| Ánh sáng | Cao | Ánh sáng không đều tạo bóng và lỗi hình ảnh |
Ứng dụng OCR trong thực tế
OCR không chỉ phục vụ một nhu cầu — đây là công nghệ nền tảng cho hàng chục ứng dụng trong nhiều ngành:
Số hóa tài liệu
Thư viện, công ty luật, cơ quan nhà nước và doanh nghiệp dùng OCR để chuyển hồ sơ giấy tích lũy qua nhiều thập kỷ thành kho lưu trữ số có thể tìm kiếm. Tài liệu trước đây phải tìm thủ công trong tủ hồ sơ nay có thể được tìm thấy trong vài giây bằng tìm kiếm toàn văn.
Nhập liệu tự động
Thay vì gõ thủ công dữ liệu từ hóa đơn, đơn đặt hàng hoặc biểu mẫu vào cơ sở dữ liệu, OCR tự động trích xuất thông tin. Công nghệ này được dùng nhiều trong kế toán công nợ phải trả, xử lý yêu cầu bồi thường bảo hiểm và quản lý hồ sơ y tế.
Khả năng tiếp cận
OCR có thể cung cấp văn bản đọc được cho công nghệ hỗ trợ. PDF đáp ứng yêu cầu tiếp cận còn cần thứ tự đọc và cấu trúc tài liệu đúng; kỹ thuật OCR của W3C bao gồm các bước kiểm tra này. Trang web này xuất văn bản thuần, không xuất PDF có thẻ cấu trúc.
Dịch vụ dịch thuật
Ứng dụng dịch dùng OCR để lấy chữ từ ảnh trước khi dịch. Khi hướng camera vào thực đơn bằng ngoại ngữ, OCR thu nhận văn bản để dịch ngay.
Tra cứu tài liệu phục vụ tố tụng
Trong tố tụng, đội ngũ pháp lý phải tìm kiếm trong hàng nghìn tài liệu. OCR chuyển tài liệu đã quét thành văn bản có thể tìm kiếm, giúp tìm từ hoặc cụm từ cụ thể trên toàn bộ tập tài liệu.
Dịch vụ tài chính
OCR có thể giúp trích xuất số tài khoản hoặc số tiền in trên ảnh tài liệu. Nhận dạng ký tự không xác minh chữ ký hay chứng minh tính xác thực của tài liệu; các bước kiểm tra đó cần quy trình riêng. Trang web này chỉ cung cấp tính năng trích xuất văn bản.
Y tế
Quản lý hồ sơ y tế ngày càng dựa vào OCR để chuyển ghi chú viết tay, báo cáo xét nghiệm và đơn thuốc thành hồ sơ điện tử có cấu trúc. Điều này cải thiện độ chính xác khi lưu hồ sơ và hỗ trợ phân tích dữ liệu tốt hơn.
Kiểm soát biên giới và an ninh
Hộ chiếu, giấy tờ tùy thân và thị thực có vùng đọc được bằng máy (MRZ), được hệ thống OCR đọc tự động tại cửa khẩu, giúp xử lý nhanh hơn và tăng độ chính xác khi xác minh.
Tự trải nghiệm công nghệ OCR
Dùng công cụ chuyển ảnh thành văn bản với một ảnh JPG/JPEG, PNG, WebP, GIF, BMP hoặc TIFF. Chọn một trong 15 ngôn ngữ nhận dạng trước khi gửi; tiếng Anh được chọn sẵn ban đầu. Quá trình nhận dạng diễn ra trên máy chủ. So sánh kết quả với ảnh, rồi sao chép hoặc tải văn bản thuần xuống. Công cụ không dịch và không dựng lại bố cục tài liệu.
Công cụ này không nhận tệp PDF đầu vào. Trước tiên dùng công cụ chuyển PDF sang ảnh, rồi nhận dạng riêng từng ảnh trang cần thiết. Giới hạn ảnh là 20 MB, 8192 px cho mỗi chiều và 25 triệu pixel. Tất cả giới hạn áp dụng đồng thời.
OCR và nhập liệu thủ công
OCR khác gì so với việc để một người gõ lại nội dung tài liệu?
| Tiêu chí | OCR | Nhập liệu thủ công |
|---|---|---|
| Tốc độ | Vài giây mỗi trang | Vài phút đến vài giờ mỗi trang |
| Chi phí | Miễn phí đến thấp | Chi phí nhân công theo trang/giờ |
| Độ chính xác | Phụ thuộc vào ảnh và mô hình nhận dạng | Phụ thuộc vào tác vụ và việc soát lại |
| Khả năng xử lý | Bị giới hạn bởi tệp, tài nguyên xử lý và giới hạn yêu cầu | Bị giới hạn bởi thời gian và nhân sự hiện có |
| Tính nhất quán | Cao | Thay đổi (mệt mỏi, mất tập trung) |
| Thời gian sẵn sàng | 24/7 | Giờ làm việc |
Khi xử lý lượng lớn tài liệu, OCR có lợi thế rõ rệt về tốc độ và chi phí. Với lượng nhỏ tài liệu rất phức tạp, cần diễn giải thay vì chỉ chép lại, việc con người xem xét vẫn có giá trị.
Giới hạn và thách thức của OCR
Dù đã tiến bộ đáng kể, OCR vẫn chưa hoàn hảo. Hiểu giới hạn giúp đặt kỳ vọng phù hợp:
Phụ thuộc vào chất lượng ảnh
Độ chính xác của OCR giảm mạnh khi ảnh kém chất lượng. Ảnh độ phân giải thấp, ảnh mờ, thiếu sáng và nén mạnh đều ảnh hưởng đến kết quả. Nguyên tắc "đầu vào kém, đầu ra kém" đặc biệt đúng trong trường hợp này.
Sự đa dạng của chữ viết tay
Dù OCR hiện đại xử lý được nhiều kiểu chữ viết tay, khác biệt giữa mỗi người vẫn là thách thức. Cách viết ký tự khác thường, khoảng cách không đều và chữ cách điệu nhiều có thể gây nhầm lẫn cho thuật toán nhận dạng.
Xử lý bố cục phức tạp
Bố cục nhiều cột, bảng, chú thích cuối trang và tài liệu có nhiều loại nội dung cần phân tích bố cục phức tạp. OCR có thể gặp khó khi chữ bao quanh ảnh hoặc các cột không được phân tách rõ.
Hỗ trợ ngôn ngữ và hệ chữ
Các ngôn ngữ phổ biến dùng bảng chữ cái Latin thường được OCR hỗ trợ rất tốt. Ngôn ngữ ít phổ biến, hệ chữ viết từ phải sang trái (tiếng Ả Rập, tiếng Hebrew) và các bộ ký tự phức tạp (tiếng Trung, tiếng Nhật, tiếng Hàn) trước đây cần bộ máy OCR chuyên biệt, dù các hệ thống AI hiện đại đã thu hẹp đáng kể khoảng cách này.
Công thức toán học và ký hiệu đặc biệt
Tài liệu kỹ thuật chứa ký hiệu toán học, công thức hóa học hoặc bộ ký hiệu ít gặp có thể gây khó cho hệ thống OCR chưa được huấn luyện riêng cho những dạng nội dung này.
Tương lai của công nghệ OCR
Tích hợp AI và học sâu
Mỗi năm, các mô hình mạng nơ-ron cho OCR đều có thêm khả năng. Hệ thống hiện đại đạt những mức chính xác mà phương pháp đối sánh mẫu truyền thống trước đây không thể đạt được. Xu hướng dùng kiến trúc transformer (cũng là công nghệ đứng sau các mô hình ngôn ngữ lớn) đang tiếp tục nâng độ chính xác của OCR.
OCR thời gian thực trên thiết bị di động
Điện thoại thông minh hiện đại có thể thực hiện OCR theo thời gian thực ngay trong khung ngắm camera. Google Lens, Live Text của Apple và các tính năng tương tự cho thấy OCR hiện đã đủ nhanh để xử lý luồng video trực tiếp trên thiết bị di động.
Hiểu tài liệu đa phương thức
Bước phát triển tiếp theo không chỉ là nhận dạng chữ mà còn hiểu đầy đủ cấu trúc và ý nghĩa của tài liệu — bảng, biểu đồ, mối quan hệ giữa văn bản và hình ảnh. Các hệ thống AI kết hợp khả năng hiểu hình ảnh và ngôn ngữ đang tiến gần mức hiểu tài liệu phức tạp của con người.
Dịch vụ OCR trên nền tảng đám mây
Dịch vụ OCR qua API từ các nhà cung cấp đám mây lớn (Google Cloud Vision, AWS Textract, Azure Computer Vision) giúp mọi nhà phát triển có khóa API tiếp cận OCR cấp doanh nghiệp. Các dịch vụ này tiếp tục cải thiện khi xử lý hàng tỷ tài liệu.
Câu hỏi thường gặp
OCR có chính xác 100% không?
Độ chính xác phụ thuộc vào ảnh nguồn, ngôn ngữ, kiểu chữ và bố cục. Ở đây không có cam kết về một tỷ lệ cố định. Hãy đối chiếu một mẫu tiêu biểu với bản gốc, đặc biệt là tên riêng và số; điểm độ tin cậy của mô hình không phải tỷ lệ chính xác ký tự đã được đo lường.
OCR có nhận dạng được mọi phông chữ không?
Phần lớn phông thông dụng (Times New Roman, Arial, Helvetica, v.v.) cho kết quả rất tốt. Phông trang trí cầu kỳ, phông mô phỏng chữ viết tay hoặc phông ít gặp có thể có tỷ lệ nhận dạng thấp hơn. Từ trước đến nay, OCR chủ yếu được tối ưu cho các phông phổ biến trong tài liệu công việc và ấn phẩm in.
OCR có nhận dạng được chữ viết tay không?
Có, nhưng có giới hạn. Chữ viết tay kiểu chữ in, với các ký tự tách rời, cho kết quả tốt hơn nhiều so với chữ viết liền nét. OCR dùng AI hiện đại đã cải thiện đáng kể khả năng nhận dạng chữ viết tay, nhưng độ chính xác vẫn thay đổi nhiều theo cách viết của mỗi người.
OCR khác gì với trích xuất văn bản từ PDF?
Trích xuất văn bản PDF đọc văn bản dạng số đã được nhúng trong tệp PDF tạo bằng phần mềm (chẳng hạn tài liệu Word lưu thành PDF). Không cần nhận dạng vì dữ liệu văn bản đã có sẵn. OCR cần thiết cho tài liệu đã quét, ảnh chụp và PDF được tạo bằng cách quét tài liệu giấy, nơi chữ chỉ tồn tại dưới dạng pixel.
OCR có nhận dạng được nhiều ngôn ngữ trong cùng một tài liệu không?
Một số hệ thống OCR hỗ trợ tự động phát hiện hoặc dùng đồng thời nhiều ngôn ngữ nhận dạng. Tại đây, hãy chọn thủ công một trong 15 ngôn ngữ; công cụ không có tính năng tự động phát hiện hay chọn kết hợp nhiều ngôn ngữ. Kiểm tra kỹ văn bản xen kẽ nhiều ngôn ngữ hoặc cắt thành các vùng phù hợp rồi xử lý riêng.
OCR xử lý bảng và dữ liệu có cấu trúc như thế nào?
Một số hệ thống xử lý tài liệu có thể dựng lại bảng. Công cụ này trả về văn bản thuần nên có thể mất cột hoặc ranh giới ô. Đối chiếu thứ tự đọc và số với bản gốc, rồi dựng lại bảng trong trình chỉnh sửa phù hợp nếu cần.
Tóm tắt
OCR đã âm thầm trở thành một trong những công nghệ có ảnh hưởng lớn nhất của thời đại số. Nó kết nối thế giới vật lý và kỹ thuật số, giúp khối lượng thông tin khổng lồ ở dạng in và viết trở nên dễ tiếp cận, tìm kiếm và xử lý.
Từ số hóa tài liệu đến dịch thời gian thực, từ hồ sơ y tế đến an ninh biên giới, OCR xuất hiện trong nhiều khía cạnh đời sống hơn mọi người thường nghĩ.
Hãy thử công cụ OCR miễn phí với một ảnh chứa chữ thuộc định dạng được hỗ trợ: JPG, PNG, WebP, GIF, BMP hoặc TIFF. Nguồn không được vượt quá 20 MB, 8.192 px cho mỗi chiều và tổng cộng 25 triệu pixel; chọn ngôn ngữ nhận dạng rồi kiểm tra kết quả.
Công cụ liên quan: Chuyển ảnh thành văn bản | PDF sang ảnh | Ảnh sang PDF
Thêm công cụ cho lần xử lý ảnh tiếp theo
Khám phá các công cụ ImgConvert để chuyển đổi, xử lý tệp PDF và GIF.
- Công cụ chuyển đổi ảnh
- Công cụ PDF
- Công cụ GIF