Riconoscimento ottico dei caratteri: guida completa alla tecnologia OCR
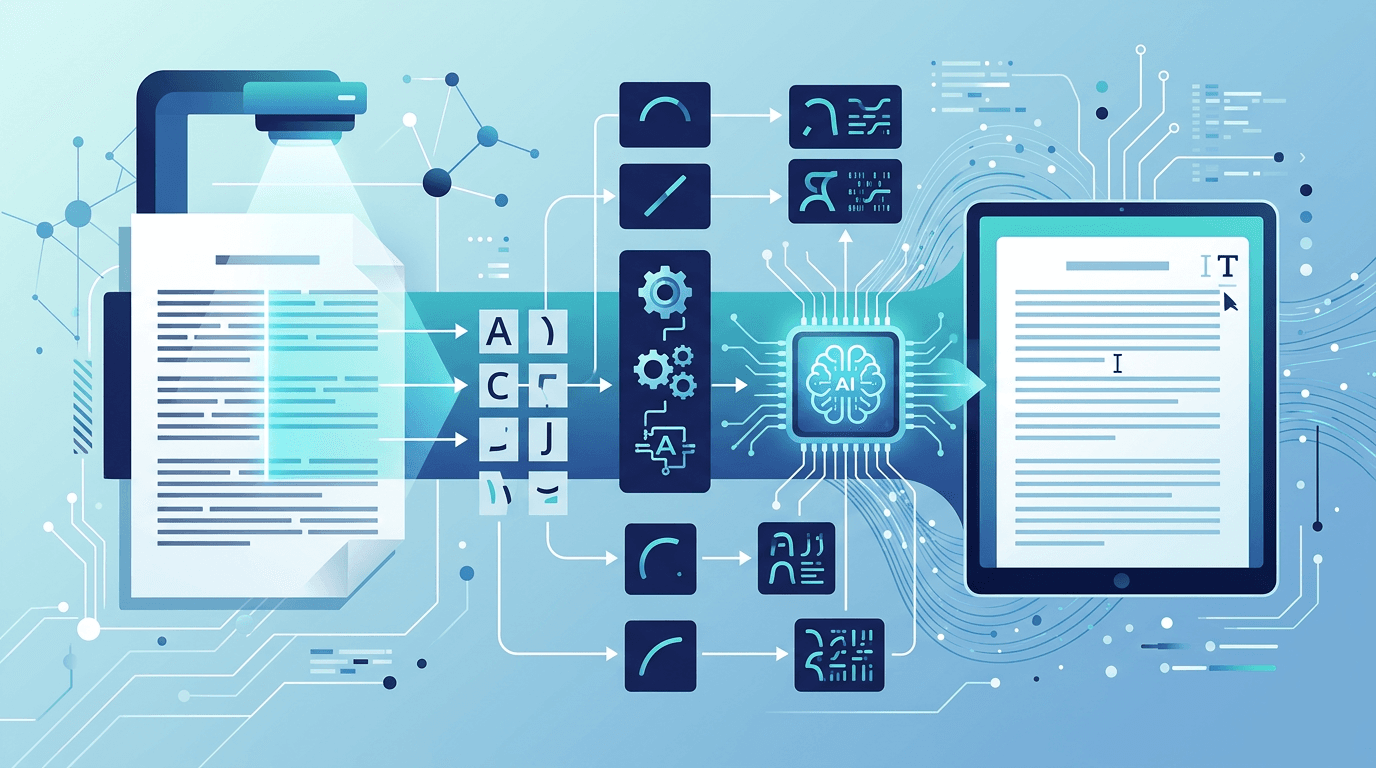
Ogni volta che fotografi uno scontrino e gli importi vengono inseriti automaticamente in un'app per le spese, oppure fotografi un biglietto da visita e i contatti vengono importati nel telefono, stai usando l'OCR. Il riconoscimento ottico dei caratteri è una di quelle tecnologie diventate indispensabili quasi senza farsi notare: è ovunque, ma poche persone sanno davvero come funziona.
Questa guida spiega che cos'è l'OCR, la tecnologia su cui si basa, dove viene usata e quali limiti presenta.
Le sezioni seguenti descrivono la tecnologia OCR in generale. Funzioni come la ricostruzione dell'impaginazione, la traduzione, il rilevamento automatico della lingua e i modelli per la scrittura a mano variano da un prodotto all'altro. Lo strumento Da immagine a testo di questo sito estrae testo semplice da una sola immagine usando una lingua selezionata manualmente; non offre queste funzioni più ampie.
Che cos'è l'OCR?
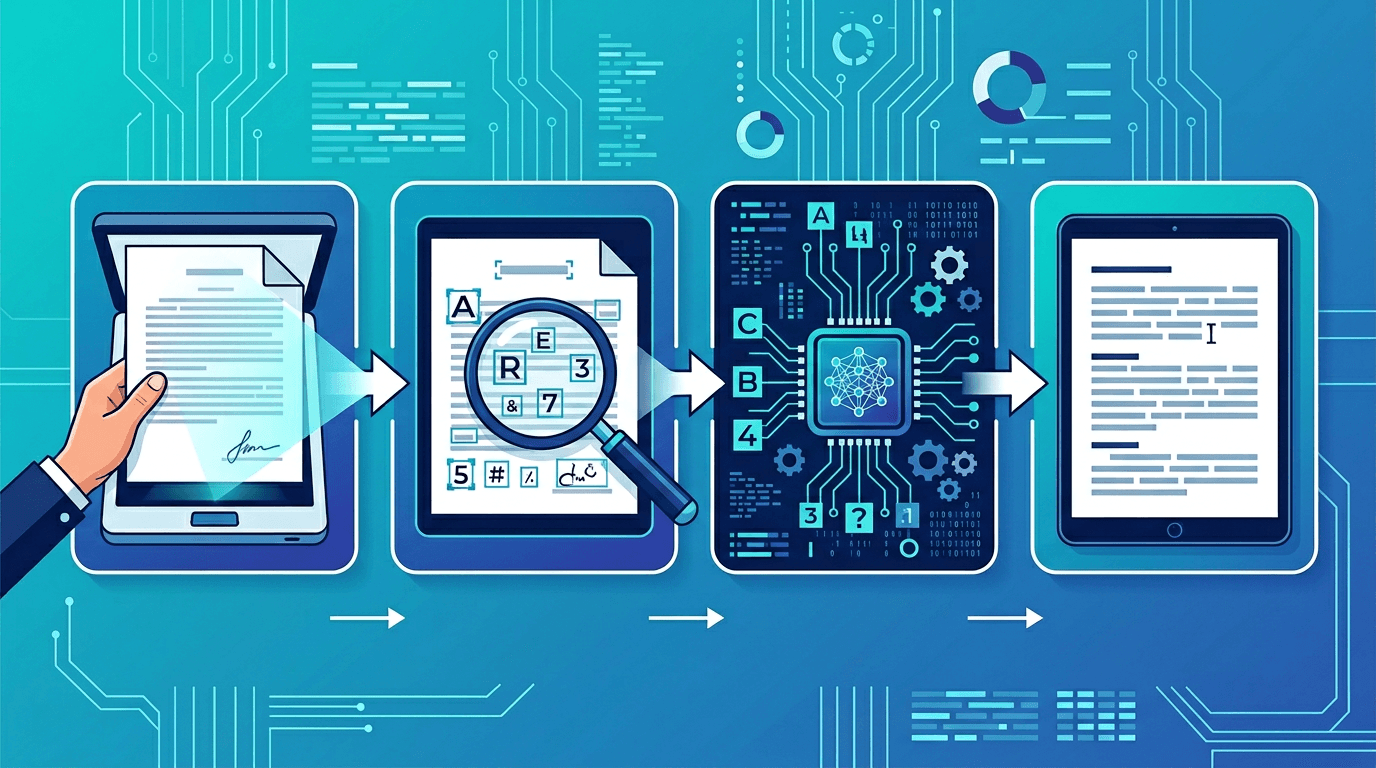
OCR è la sigla di Optical Character Recognition, cioè riconoscimento ottico dei caratteri. È una tecnologia che permette ai computer di individuare ed estrarre testo da immagini, documenti acquisiti con lo scanner e fotografie, trasformando il testo visibile in testo digitale leggibile da una macchina.
L'OCR svolge quattro funzioni fondamentali:
- Riconosce il testo — in immagini, documenti scansionati e foto
- Converte il testo visibile — in un formato digitale modificabile e ricercabile
- Permette la ricerca — in contenuti basati su immagini che prima non erano ricercabili
- Automatizza l'inserimento dei dati — estraendo informazioni da documenti cartacei
Prima dell'OCR, la fotografia di un documento era soltanto una fotografia: per un computer, il testo al suo interno era come se non esistesse. L'OCR collega il mondo fisico del testo stampato a quello digitale dei dati ricercabili ed elaborabili.
Come funziona la tecnologia OCR
L'OCR moderno comprende una sequenza articolata di processi. Capire queste fasi aiuta a spiegare sia l'elevata accuratezza in condizioni favorevoli sia le difficoltà nelle situazioni più complesse.
Fase 1: acquisizione dell'immagine
Il processo inizia con l'acquisizione o l'importazione dell'immagine:
- Scansione di un documento cartaceo con uno scanner piano o per documenti
- Fotografia del testo con la fotocamera di uno smartphone
- Acquisizione di una schermata
- Importazione di un file esistente (JPG, PNG, PDF, TIFF, ecc.)
La qualità in questa fase è fondamentale: determina il limite di ciò che si può ottenere nelle fasi successive. Una foto sfocata o poco illuminata produce risultati peggiori rispetto a una scansione nitida e ad alta risoluzione.
Fase 2: pre-elaborazione dell'immagine
Prima del riconoscimento dei caratteri, l'immagine viene sottoposta a diverse operazioni di miglioramento:
- Binarizzazione: converte l'immagine in bianco e nero puro. Elimina le informazioni sul colore e semplifica l'immagine, rendendo più facile distinguere il testo dallo sfondo.
- Riduzione del rumore: elimina puntini, grana e artefatti che potrebbero essere scambiati per caratteri.
- Correzione dell'inclinazione: corregge i documenti inclinati o ruotati. Se fotografi una pagina leggermente storta, questo passaggio la raddrizza.
- Rimozione dei puntini: elimina piccoli punti casuali dall'immagine.
- Analisi dell'impaginazione: individua e separa le diverse aree, come testo principale, intestazioni, riquadri laterali, tabelle e immagini, per elaborarle in modo appropriato.
Fase 3: riconoscimento dei caratteri
È qui che avviene l'identificazione vera e propria del testo. I motori OCR moderni usano più approcci contemporaneamente:
Confronto di forme: confronta i singoli caratteri con una raccolta di forme note. È efficace con caratteri tipografici standard e ben definiti.
Rilevamento delle caratteristiche: analizza le proprietà strutturali distintive di ogni carattere, come curve, intersezioni e spazi chiusi. Per esempio, la lettera "B" ha due aree chiuse sul lato destro, mentre la "P" ne ha una. Queste caratteristiche permettono di riconoscere i caratteri anche quando la forma esatta varia.
Reti neurali: i motori OCR moderni usano modelli di apprendimento profondo addestrati su milioni di campioni di testo. Questi modelli hanno imparato a riconoscere caratteri in un'enorme varietà di stili tipografici, dimensioni, grafie e condizioni dell'immagine.
Analisi del contesto: dopo l'identificazione dei singoli caratteri, l'analisi linguistica migliora i risultati. Se il riconoscimento ha rilevato "h0use" invece di "house", il modello linguistico capisce che in quel contesto lo "0" è più probabilmente una "o", in base alle parole circostanti e ai modelli della lingua.
Fase 4: post-elaborazione
L'ultima fase perfeziona e prepara il risultato:
- Controllo ortografico: segnala e corregge gli errori evidenti consultando un dizionario
- Conservazione dell'impaginazione: mantiene la struttura del documento originale, come colonne, tabelle e interruzioni di paragrafo
- Valutazione della confidenza: assegna una percentuale di confidenza a ogni carattere o parola riconosciuta, permettendo alle applicazioni di segnalare i risultati meno affidabili per una revisione umana
- Formattazione del risultato: esporta nel formato desiderato, come testo semplice, PDF ricercabile, documento Word o dati strutturati
Tipi di tecnologia OCR
OCR standard
Il tipo originale e più diffuso:
- Riconosce il testo stampato con caratteri tipografici standard
- Funziona meglio con immagini nitide e di qualità, in buone condizioni di illuminazione
- Offre la maggiore accuratezza nell'elaborazione di documenti formali
- Funziona con la grande maggioranza dei materiali stampati
Riconoscimento intelligente dei caratteri (ICR)
Un'evoluzione progettata appositamente per la scrittura a mano:
- Usa tecniche avanzate di apprendimento automatico per gestire grafie diverse
- Migliora progressivamente con l'esposizione a più esempi
- Resta meno accurato dell'OCR standard sul testo stampato
- Viene usato per elaborare assegni bancari, digitalizzare documenti storici ed elaborare moduli
Riconoscimento intelligente delle parole (IWR)
Adotta un approccio d'insieme, riconoscendo parole intere anziché singoli caratteri:
- È più efficace con il corsivo e le grafie in cui i caratteri sono collegati
- L'elaborazione basata sul contesto migliora l'accuratezza
- Si combina con modelli linguistici per il testo in linguaggio naturale
- Viene usato nello smistamento della posta e nella digitalizzazione dei moduli
Riconoscimento ottico dei segni (OMR)
Una variante specializzata nel rilevamento dei segni anziché nella lettura del testo:
- Identifica caselle, cerchietti e segni, compilati o vuoti
- Viene usato per test standardizzati, sondaggi e scansione di schede elettorali
- Rilevamento binario: contrassegnato o non contrassegnato
- Accuratezza molto elevata quando l'immagine è di buona qualità
Riconoscimento di codici a barre e QR Code
Pur essendo tecnicamente distinte dall'OCR del testo, queste tecnologie correlate:
- Leggono codici a barre 1D e 2D
- Decodificano i QR Code
- Estraggono dati codificati anziché testo visibile
- Sono integrate in molte applicazioni che offrono anche l'OCR
Fattori che influiscono sull'accuratezza dell'OCR
Capire cosa favorisce o ostacola l'OCR aiuta a ottenere risultati migliori:
| Fattore | Impatto sull'accuratezza | Note |
|---|---|---|
| Risoluzione dell'immagine | Alto | Servono abbastanza pixel per distinguere ogni carattere; il solo valore DPI nei metadati non basta |
| Nitidezza dell'immagine | Molto alto | La sfocatura è il principale nemico della qualità |
| Contrasto del testo | Alto | L'ideale è testo scuro su sfondo chiaro |
| Tipo di carattere | Medio-alto | Caratteri standard > caratteri decorativi |
| Condizioni del documento | Medio | Pieghe, macchie e danni riducono l'accuratezza |
| Complessità della lingua | Medio | I sistemi di scrittura latini sono più semplici di quelli complessi |
| Scrittura a mano | Alto | Le differenze individuali rendono il riconoscimento difficile |
| Illuminazione | Alto | Una luce non uniforme crea ombre e artefatti |
Applicazioni concrete dell'OCR
L'OCR non ha un solo impiego: è una tecnologia di base che sostiene decine di applicazioni in molti settori:
Digitalizzazione di documenti
Biblioteche, studi legali, enti pubblici e aziende usano l'OCR per convertire decenni di archivi cartacei in archivi digitali ricercabili. Un documento che prima richiedeva una ricerca manuale negli schedari può essere trovato in pochi secondi con una ricerca nel testo completo.
Inserimento automatico dei dati
Invece di digitare manualmente nei database i dati di fatture, ordini d'acquisto o moduli, l'OCR estrae automaticamente le informazioni. Questa funzione è molto usata nella contabilità fornitori, nella gestione delle pratiche assicurative e degli archivi sanitari.
Accessibilità
L'OCR può fornire testo leggibile alle tecnologie assistive. Un PDF accessibile richiede anche un ordine di lettura e una struttura del documento corretti; la tecnica OCR del W3C include questi controlli. Questo sito esporta testo semplice, non un PDF con tag.
Servizi di traduzione
Le app di traduzione usano l'OCR per estrarre il testo dalle immagini prima di tradurlo. Inquadrando con la fotocamera un menu in lingua straniera, l'OCR acquisisce il testo per la traduzione immediata.
Ricerca documentale in ambito legale
Durante una controversia, i team legali devono cercare informazioni in migliaia di documenti. L'OCR converte i documenti scansionati in testo ricercabile, permettendo di cercare termini o frasi specifiche in intere raccolte.
Servizi finanziari
L'OCR può aiutare a estrarre numeri di conto o importi stampati dalle immagini dei documenti. Riconoscere i caratteri non significa verificare una firma o stabilire l'autenticità del documento: queste verifiche richiedono un processo separato. Questo sito offre soltanto l'estrazione del testo.
Sanità
La gestione delle cartelle cliniche si affida sempre più all'OCR per convertire appunti scritti a mano, referti di laboratorio e prescrizioni in documenti elettronici strutturati. Questo migliora l'accuratezza della registrazione e permette analisi dei dati più efficaci.
Controlli di frontiera e sicurezza
Passaporti, documenti d'identità e visti usano zone a lettura ottica (MRZ) che i sistemi OCR leggono automaticamente ai valichi di frontiera, accelerando le procedure e migliorando l'accuratezza delle verifiche.
Prova la tecnologia OCR
Usa Da immagine a testo con un solo file JPG/JPEG, PNG, WebP, GIF, BMP o TIFF. Scegli una delle 15 lingue di riconoscimento prima di inviarlo; all'inizio è selezionato l'inglese. Il riconoscimento avviene sul server. Confronta il risultato con l'immagine, poi copia o scarica il testo semplice. Lo strumento non traduce né ricostruisce l'impaginazione del documento.
Qui non è possibile caricare PDF. Usa prima Da PDF a immagine e riconosci singolarmente le immagini delle pagine necessarie. I limiti delle immagini sono 20 MB, 8192 px per lato e 25 milioni di pixel. Si applicano tutti contemporaneamente.
OCR e inserimento manuale dei dati a confronto
Come si confronta l'OCR con la trascrizione manuale del contenuto di un documento?
| Aspetto | OCR | Inserimento manuale dei dati |
|---|---|---|
| Velocità | Secondi per pagina | Da minuti a ore per pagina |
| Costo | Da gratuito a contenuto | Costo del lavoro per pagina o ora |
| Accuratezza | Dipende dall'immagine e dal modello di riconoscimento | Dipende dal compito e dalla revisione |
| Capacità | Limitata da file, risorse di elaborazione e limiti delle richieste | Limitata dal tempo e dal personale disponibili |
| Uniformità | Alta | Variabile per stanchezza e distrazioni |
| Disponibilità | 24/7 | Orario lavorativo |
Per elaborare grandi quantità di documenti, l'OCR offre vantaggi netti in termini di velocità e costo. Per pochi documenti molto complessi, che richiedono interpretazione oltre alla trascrizione, la revisione umana resta preziosa.
Limiti e difficoltà dell'OCR
Nonostante i progressi, l'OCR non è perfetto. Conoscerne i limiti aiuta ad avere aspettative realistiche:
Dipendenza dalla qualità dell'immagine
L'accuratezza dell'OCR cala nettamente quando l'immagine è scadente. Bassa risoluzione, foto sfocate, illuminazione insufficiente e compressione elevata influiscono sui risultati. Qui vale pienamente il principio secondo cui dati di scarsa qualità producono risultati di scarsa qualità.
Variabilità della scrittura a mano
L'OCR moderno gestisce molti tipi di grafia, ma le differenze individuali restano una difficoltà. Lettere dalle forme insolite, spaziatura irregolare e scrittura molto stilizzata possono confondere gli algoritmi di riconoscimento.
Gestione di impaginazioni complesse
Documenti a più colonne, tabelle, note a piè di pagina e contenuti misti richiedono un'analisi avanzata dell'impaginazione. L'OCR può avere difficoltà quando il testo circonda le immagini o le colonne non sono separate chiaramente.
Supporto per lingue e sistemi di scrittura
Le principali lingue con alfabeto latino hanno generalmente un ottimo supporto OCR. Le lingue meno comuni, i sistemi di scrittura da destra a sinistra (arabo, ebraico) e quelli con caratteri complessi (cinese, giapponese, coreano) hanno storicamente richiesto motori OCR specializzati, anche se i moderni sistemi basati sull'IA hanno ridotto notevolmente questo divario.
Formule matematiche e simboli speciali
I documenti tecnici con notazione matematica, formule chimiche o simboli insoliti possono mettere in difficoltà i sistemi OCR non addestrati specificamente su questi formati.
Il futuro della tecnologia OCR
Integrazione di IA e apprendimento profondo
Ogni anno, i modelli a reti neurali per l'OCR diventano più capaci. I sistemi moderni raggiungono livelli di accuratezza che sarebbero stati impossibili con i tradizionali approcci di confronto delle forme. La diffusione delle architetture transformer, la stessa tecnologia alla base dei modelli linguistici di grandi dimensioni, sta spingendo l'accuratezza dell'OCR ancora più in alto.
OCR mobile in tempo reale
Gli smartphone moderni possono eseguire l'OCR in tempo reale direttamente nel mirino della fotocamera. Google Lens, Testo attivo di Apple e funzioni simili mostrano che l'OCR è ormai abbastanza veloce da funzionare su un flusso video in diretta su un dispositivo mobile.
Comprensione multimodale dei documenti
La prossima frontiera non è solo riconoscere il testo, ma comprendere l'intera struttura e il significato dei documenti: tabelle, grafici e relazioni tra testo e immagini. I sistemi di IA che combinano comprensione visiva e linguistica si avvicinano alla capacità umana di comprendere documenti complessi.
Servizi OCR nel cloud
I servizi OCR via API dei principali fornitori cloud (Google Cloud Vision, AWS Textract, Azure Computer Vision) rendono l'OCR di livello aziendale accessibile a qualsiasi sviluppatore con una chiave API. Questi servizi continuano a migliorare elaborando miliardi di documenti.
Domande frequenti
L'OCR è accurato al 100%?
L'accuratezza del riconoscimento dipende dall'immagine sorgente, dalla lingua, dai caratteri e dall'impaginazione. Qui non viene promessa una percentuale fissa. Confronta un campione rappresentativo con l'originale, soprattutto per nomi e numeri; il punteggio di confidenza del modello non è una misura dell'accuratezza dei caratteri riconosciuti.
L'OCR può riconoscere qualsiasi carattere tipografico?
La maggior parte dei caratteri standard (Times New Roman, Arial, Helvetica, ecc.) funziona molto bene. I caratteri molto decorativi, calligrafici o insoliti possono avere tassi di riconoscimento inferiori. Storicamente l'OCR è stato ottimizzato per i caratteri più comuni nei documenti aziendali e nella stampa.
L'OCR funziona con la scrittura a mano?
Sì, con alcuni limiti. Lo stampatello funziona molto meglio del corsivo. L'OCR moderno basato sull'IA ha migliorato notevolmente il riconoscimento della scrittura a mano, ma l'accuratezza varia molto in base alla grafia individuale.
Qual è la differenza tra OCR ed estrazione del testo dai PDF?
L'estrazione del testo dai PDF legge il testo digitale incorporato nei PDF creati digitalmente, come un documento Word salvato in PDF. Non serve il riconoscimento, perché i dati testuali sono già presenti. L'OCR è necessario per documenti scansionati, foto e PDF ottenuti dalla scansione di documenti cartacei, dove il testo esiste soltanto sotto forma di pixel.
L'OCR può riconoscere più lingue nello stesso documento?
Alcuni sistemi OCR supportano il rilevamento automatico o più lingue di riconoscimento contemporaneamente. Qui scegli manualmente una delle 15 lingue: non sono disponibili il rilevamento automatico e la selezione combinata di più lingue. Controlla con attenzione i testi multilingua oppure elabora separatamente aree ritagliate in modo appropriato.
Come gestisce l'OCR tabelle e dati strutturati?
Alcuni sistemi di elaborazione documentale ricostruiscono le tabelle. Questo strumento restituisce testo semplice, quindi le colonne o i confini delle celle possono andare persi. Confronta l'ordine di lettura e i numeri con l'originale e, se necessario, ricostruisci la tabella in un editor adatto.
Riepilogo
L'OCR è diventato, quasi senza farsi notare, una delle tecnologie più importanti dell'era digitale. Collega il mondo fisico e quello digitale, rendendo accessibile, ricercabile ed elaborabile l'enorme quantità di informazioni stampate e scritte.
Dalla digitalizzazione dei documenti alla traduzione in tempo reale, dalle cartelle cliniche alla sicurezza delle frontiere, l'OCR è presente in più aspetti della vita quotidiana di quanto si pensi.
Provalo con il nostro strumento OCR gratuito: carica un'immagine con testo e osserva la tecnologia in azione.
Strumenti correlati: Da immagine a testo | Da PDF a immagine | Da immagine a PDF
Altri strumenti per lavorare con le immagini
Esplora gli strumenti di ImgConvert per la conversione, i file PDF e le GIF.
- Convertitori di immagini
- Strumenti PDF
- Strumenti GIF