Cara Kerja OCR: Panduan Lengkap Teknologi Pengenalan Karakter Optik
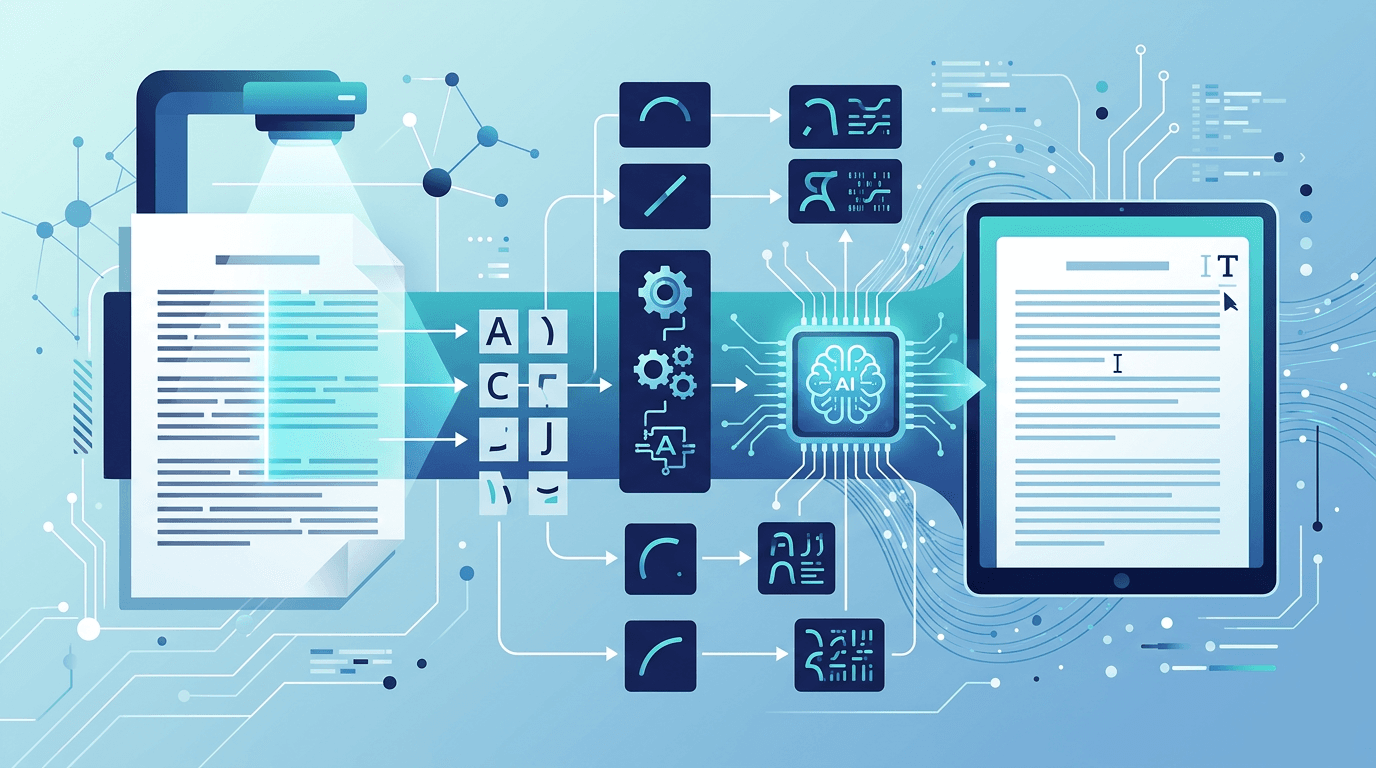
Setiap kali Anda memotret struk lalu nominalnya dimasukkan secara otomatis ke aplikasi pencatat pengeluaran, atau memotret kartu nama lalu detail kontaknya diimpor ke ponsel, Anda sedang melihat OCR bekerja. Optical Character Recognition, atau pengenalan karakter optik, adalah salah satu teknologi yang tanpa banyak disadari telah menjadi sangat penting — digunakan di mana-mana, tetapi kebanyakan orang belum memahami cara kerjanya.
Panduan ini menjelaskan apa itu OCR, teknologi di baliknya, tempat penggunaannya, dan keterbatasannya.
Bagian-bagian di bawah menjelaskan teknologi OCR secara umum. Fitur seperti rekonstruksi tata letak, penerjemahan, deteksi bahasa otomatis, dan model tulisan tangan berbeda pada tiap produk. Alat Gambar ke Teks di situs ini mengekstrak teks biasa dari satu gambar dengan satu bahasa yang dipilih secara manual; alat ini tidak menyediakan fitur yang lebih luas tersebut.
Apa Itu OCR?
OCR adalah singkatan dari Optical Character Recognition. Teknologi pengenalan karakter optik ini memungkinkan komputer mengenali dan mengekstrak teks dari gambar, dokumen hasil pindai, dan foto, lalu mengubah teks visual menjadi teks digital yang dapat dibaca mesin.
Pada dasarnya, OCR melakukan empat hal:
- Mengenali teks — dalam gambar, dokumen hasil pindai, dan foto
- Mengubah teks visual — menjadi format digital yang dapat diedit dan ditelusuri
- Memungkinkan pencarian — dalam konten berbasis gambar yang sebelumnya tidak dapat ditelusuri
- Mengotomatiskan entri data — dengan mengekstrak informasi dari dokumen fisik
Sebelum ada OCR, foto dokumen hanyalah foto — komputer tidak dapat memperlakukan tulisan di dalamnya sebagai teks. OCR menghubungkan dunia fisik teks cetak dengan dunia digital yang berisi data yang dapat ditelusuri dan diproses.
Cara Kerja Teknologi OCR
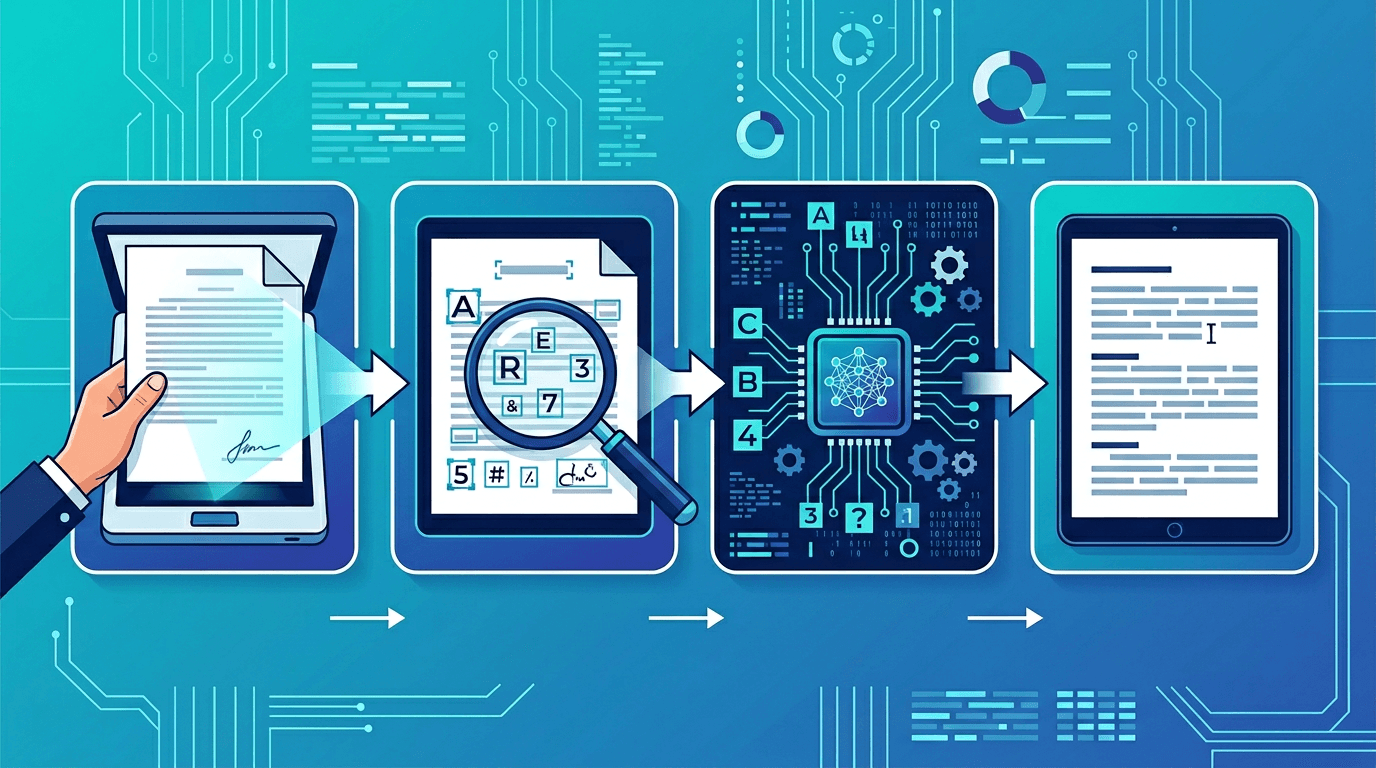
OCR modern melibatkan rangkaian proses yang kompleks. Memahami tahap-tahap ini membantu menjelaskan mengapa OCR sangat akurat dalam kondisi yang baik dan mengapa teknologi ini kesulitan dalam kondisi yang menantang.
Tahap 1: Pengambilan Gambar
Proses dimulai dengan mengambil atau mengimpor gambar:
- Memindai dokumen fisik dengan pemindai datar atau pemindai dokumen
- Memotret teks dengan kamera ponsel
- Mengambil tangkapan layar dari konten di layar
- Mengimpor berkas gambar yang sudah ada (JPG, PNG, PDF, TIFF, dan sebagainya)
Kualitas pada tahap ini sangat menentukan — kualitas tersebut membatasi hasil terbaik yang dapat dicapai pada tahap selanjutnya. Foto buram atau kurang terang akan memberikan hasil yang lebih buruk daripada hasil pindai yang bersih dan beresolusi tinggi.
Tahap 2: Prapemrosesan Gambar
Sebelum pengenalan karakter dimulai, gambar melalui beberapa langkah perbaikan:
- Binarisasi: Mengubah gambar menjadi hitam dan putih murni. Langkah ini menghapus informasi warna dan menyederhanakan gambar agar teks lebih mudah dibedakan dari latar belakang.
- Pengurangan derau: Menghilangkan bintik, butiran, dan artefak gambar yang dapat disalahartikan sebagai karakter.
- Koreksi kemiringan: Memperbaiki dokumen yang miring atau terputar. Jika Anda memotret halaman dengan sedikit kemiringan, tahap ini meluruskannya.
- Penghilangan bintik: Menghapus titik-titik kecil acak pada gambar.
- Analisis tata letak: Mengenali dan memisahkan berbagai area — teks utama, judul bagian, kolom samping, tabel, dan gambar — agar masing-masing dapat diproses dengan tepat.
Tahap 3: Pengenalan Karakter
Pada tahap inilah teks benar-benar dikenali. Mesin OCR modern menggunakan beberapa pendekatan sekaligus:
Pencocokan pola: Membandingkan setiap karakter dengan kumpulan bentuk karakter yang sudah dikenal. Cara ini efektif untuk font standar dengan bentuk yang jelas.
Deteksi fitur: Menganalisis ciri struktur unik tiap karakter — lengkungan, perpotongan, dan ruang tertutup. Misalnya, huruf "B" memiliki dua lengkungan tertutup di sisi kanan, sedangkan huruf "P" memiliki satu. Ciri struktur ini memungkinkan karakter dikenali meskipun bentuk persisnya bervariasi.
Jaringan saraf: Mesin OCR modern menggunakan model pembelajaran mendalam yang dilatih dengan jutaan sampel teks. Model-model ini telah belajar mengenali karakter dalam beragam font, ukuran, gaya tulisan tangan, dan kondisi gambar.
Analisis konteks: Setelah setiap karakter dikenali, analisis bahasa memperbaiki hasilnya. Jika deteksi karakter membaca "h0use" alih-alih "house", model bahasa mengenali bahwa "0" dalam konteks ini lebih mungkin merupakan "o" berdasarkan kata-kata di sekitarnya dan pola bahasa.
Tahap 4: Pascapemrosesan
Tahap terakhir menyempurnakan dan menyiapkan keluaran:
- Pemeriksaan ejaan: Menandai dan memperbaiki kesalahan yang jelas dengan merujuk pada kamus
- Pemeliharaan tata letak: Mempertahankan struktur format dokumen asli (kolom, tabel, pemisah paragraf)
- Penilaian keyakinan: Memberikan persentase keyakinan untuk setiap karakter atau kata yang dikenali, sehingga aplikasi dapat menandai hasil berkeyakinan rendah untuk diperiksa manusia
- Pemformatan keluaran: Mengekspor hasil dalam format yang diinginkan (teks biasa, PDF yang dapat ditelusuri, dokumen Word, data terstruktur)
Jenis Teknologi OCR
OCR Standar
Jenis awal dan yang paling umum:
- Mengenali teks cetak dengan font standar
- Memberikan hasil terbaik pada gambar bersih berkualitas tinggi dengan pencahayaan yang baik
- Paling akurat untuk pemrosesan dokumen formal
- Dapat digunakan pada sebagian besar bahan cetak
Pengenalan Karakter Cerdas (ICR)
Pengembangan yang dirancang khusus untuk tulisan tangan:
- Menggunakan pembelajaran mesin tingkat lanjut untuk menangani beragam gaya tulisan tangan
- Terus berkembang dengan mempelajari lebih banyak contoh
- Masih kurang akurat dibandingkan OCR standar untuk teks cetak
- Digunakan dalam pemrosesan cek bank, digitalisasi dokumen sejarah, dan pemrosesan formulir
Pengenalan Kata Cerdas (IWR)
Menggunakan pendekatan menyeluruh dengan mengenali kata utuh, bukan karakter satu per satu:
- Lebih efektif untuk tulisan tangan sambung yang karakternya menyatu
- Pemrosesan yang mempertimbangkan konteks meningkatkan akurasi
- Dipadukan dengan model bahasa untuk teks alami
- Digunakan dalam penyortiran surat dan digitalisasi formulir
Pengenalan Tanda Optik (OMR)
Varian khusus untuk mendeteksi tanda, bukan membaca teks:
- Mengenali kotak centang, lingkaran isian, dan tanda (terisi atau kosong)
- Digunakan pada ujian standar, survei, dan pemindaian surat suara
- Deteksi biner: ditandai atau tidak ditandai
- Sangat akurat jika kualitas gambar baik
Pengenalan Barcode dan Kode QR
Meskipun secara teknis terpisah dari OCR teks, teknologi terkait ini:
- Membaca barcode 1D dan 2D
- Mendekode kode QR
- Mengekstrak data yang dikodekan, bukan teks visual
- Diintegrasikan ke dalam banyak aplikasi yang memiliki kemampuan OCR
Faktor yang Memengaruhi Akurasi OCR
Memahami hal-hal yang membuat OCR bekerja dengan baik atau buruk membantu Anda memperoleh hasil yang lebih baik:
| Faktor | Pengaruh terhadap Akurasi | Catatan |
|---|---|---|
| Resolusi gambar | Tinggi | Diperlukan piksel yang cukup untuk membedakan setiap karakter; tag DPI saja tidak cukup |
| Ketajaman gambar | Sangat tinggi | Keburaman merupakan penyebab utama penurunan kualitas |
| Kontras teks | Tinggi | Teks gelap pada latar terang adalah kondisi ideal |
| Jenis font | Sedang–Tinggi | Font standar > font dekoratif |
| Kondisi dokumen | Sedang | Lipatan, noda, dan kerusakan mengurangi akurasi |
| Kerumitan bahasa | Sedang | Aksara Latin lebih mudah dikenali daripada aksara yang kompleks |
| Tulisan tangan | Tinggi | Variasi antarindividu menyulitkan pengenalan |
| Pencahayaan | Tinggi | Pencahayaan tidak merata menimbulkan bayangan dan artefak |
Penerapan OCR dalam Kehidupan Nyata
OCR tidak terbatas pada satu kegunaan — teknologi ini menjadi dasar bagi puluhan aplikasi di berbagai industri:
Digitalisasi Dokumen
Perpustakaan, firma hukum, lembaga pemerintah, dan perusahaan menggunakan OCR untuk mengubah arsip kertas selama puluhan tahun menjadi arsip digital yang dapat ditelusuri. Dokumen yang dahulu harus dicari secara manual di lemari arsip kini dapat ditemukan dalam hitungan detik melalui pencarian teks lengkap.
Entri Data Otomatis
Alih-alih mengetik data dari faktur, pesanan pembelian, atau formulir ke basis data secara manual, OCR mengekstrak informasi secara otomatis. Penerapannya banyak ditemukan dalam pengelolaan utang usaha, pemrosesan klaim asuransi, dan pengelolaan rekam medis.
Aksesibilitas
OCR dapat menyediakan teks yang dapat dibaca oleh teknologi bantu. PDF yang aksesibel juga memerlukan urutan baca dan struktur dokumen yang benar; teknik OCR dari W3C mencakup pemeriksaan ini. Situs ini mengekspor teks biasa, bukan PDF bertag.
Layanan Penerjemahan
Aplikasi penerjemahan menggunakan OCR untuk mengekstrak teks dari gambar sebelum menerjemahkannya. Saat Anda mengarahkan kamera ke menu berbahasa asing, OCR mengambil teksnya untuk segera diterjemahkan.
Penelusuran Dokumen Hukum
Dalam proses litigasi, tim hukum perlu menelusuri ribuan dokumen. OCR mengubah dokumen hasil pindai menjadi teks yang dapat ditelusuri, sehingga seluruh kumpulan dokumen dapat dicari berdasarkan istilah atau frasa tertentu.
Layanan Keuangan
OCR dapat membantu mengekstrak nomor rekening atau nominal yang tercetak pada gambar dokumen. Pengenalan karakter tidak memverifikasi tanda tangan atau membuktikan keaslian dokumen; pemeriksaan tersebut memerlukan proses terpisah. Situs ini hanya menyediakan ekstraksi teks.
Layanan Kesehatan
Pengelolaan rekam medis semakin mengandalkan OCR untuk mengubah catatan tulisan tangan, laporan laboratorium, dan resep menjadi catatan elektronik terstruktur. Hal ini meningkatkan ketepatan pencatatan dan memungkinkan analisis data yang lebih baik.
Pemeriksaan Perbatasan dan Keamanan
Paspor, dokumen identitas, dan visa menggunakan zona yang dapat dibaca mesin (MRZ), yang dibaca secara otomatis oleh sistem OCR di pos pemeriksaan perbatasan untuk mempercepat proses dan meningkatkan akurasi verifikasi.
Coba Sendiri Teknologi OCR
Gunakan Gambar ke Teks dengan satu berkas JPG/JPEG, PNG, WebP, GIF, BMP, atau TIFF. Pilih salah satu dari 15 bahasa pengenalan sebelum mengirim; bahasa Inggris dipilih secara default. Pengenalan dijalankan di server. Bandingkan hasil dengan gambar, lalu salin atau unduh teks biasa. Alat ini tidak menerjemahkan atau merekonstruksi tata letak dokumen.
Masukan PDF tidak diterima di sini. Gunakan PDF ke Gambar terlebih dahulu, lalu kenali teks dari gambar halaman yang diperlukan satu per satu. Batas gambar adalah 20 MB, 8192 px per sisi, dan 25 juta piksel. Semua batas berlaku secara bersamaan.
OCR dibandingkan Entri Data Manual
Bagaimana perbandingan OCR dengan pengetikan isi dokumen secara manual oleh manusia?
| Aspek | OCR | Entri Data Manual |
|---|---|---|
| Kecepatan | Hitungan detik per halaman | Hitungan menit hingga jam per halaman |
| Biaya | Gratis hingga rendah | Biaya tenaga kerja per halaman/jam |
| Akurasi | Bergantung pada gambar dan model pengenalan | Bergantung pada tugas dan pemeriksaan ulang |
| Kapasitas | Dibatasi oleh berkas, sumber daya pemrosesan, dan batas permintaan | Dibatasi oleh waktu dan tenaga yang tersedia |
| Konsistensi | Tinggi | Bervariasi (kelelahan, gangguan perhatian) |
| Ketersediaan | 24/7 | Jam kerja |
Untuk pemrosesan dokumen dalam jumlah besar, OCR jauh lebih unggul dalam kecepatan dan biaya. Untuk dokumen yang jumlahnya sedikit tetapi sangat kompleks dan memerlukan interpretasi, bukan sekadar penyalinan teks, pemeriksaan manusia tetap berharga.
Keterbatasan dan Tantangan OCR
Meskipun telah mengalami kemajuan besar, OCR belum sempurna. Memahami keterbatasannya membantu Anda menetapkan harapan yang sesuai:
Ketergantungan pada Kualitas Gambar
Akurasi OCR menurun tajam jika kualitas gambar buruk. Gambar beresolusi rendah, foto buram, pencahayaan buruk, dan kompresi tinggi memengaruhi hasilnya. Prinsip "masukan buruk menghasilkan keluaran buruk" sangat berlaku di sini.
Variasi Tulisan Tangan
Walaupun OCR modern dapat menangani banyak gaya tulisan tangan, variasi antarindividu tetap menjadi tantangan. Bentuk huruf yang tidak lazim, spasi yang tidak konsisten, dan tulisan yang sangat bergaya dapat membingungkan algoritma pengenalan.
Penanganan Tata Letak Kompleks
Tata letak multikolom, tabel, catatan kaki, dan dokumen dengan konten campuran memerlukan analisis tata letak yang canggih. OCR dapat kesulitan jika teks mengelilingi gambar atau batas antarkolom tidak jelas.
Dukungan Bahasa dan Aksara
Bahasa-bahasa utama dengan alfabet Latin umumnya memiliki dukungan OCR yang sangat baik. Bahasa yang kurang umum, aksara dari kanan ke kiri (Arab, Ibrani), serta kumpulan karakter kompleks (Mandarin, Jepang, Korea) dahulu memerlukan mesin OCR khusus, meskipun sistem modern berbasis AI telah banyak memperkecil kesenjangan ini.
Rumus Matematika dan Simbol Khusus
Dokumen teknis yang berisi notasi matematika, rumus kimia, atau kumpulan simbol yang tidak umum dapat menyulitkan sistem OCR yang tidak dilatih khusus untuk format tersebut.
Masa Depan Teknologi OCR
Integrasi AI dan Pembelajaran Mendalam
Setiap tahun, model jaringan saraf untuk OCR menjadi semakin mampu. Sistem modern mencapai tingkat akurasi yang dahulu tidak mungkin diperoleh dengan pendekatan pencocokan pola tradisional. Peralihan ke arsitektur berbasis transformer (teknologi yang juga mendasari model bahasa besar) terus meningkatkan akurasi OCR.
OCR Ponsel secara Real Time
Ponsel modern dapat menjalankan OCR secara langsung di jendela bidik kamera. Google Lens, Live Text dari Apple, dan fitur serupa menunjukkan bahwa OCR kini cukup cepat untuk bekerja pada aliran video langsung di perangkat seluler.
Pemahaman Dokumen Multimodal
Tahap berikutnya bukan hanya mengenali teks, tetapi memahami seluruh struktur dan makna dokumen — tabel, grafik, serta hubungan antara teks dan gambar. Sistem AI yang menggabungkan pemahaman visual dan bahasa semakin mendekati kemampuan manusia dalam memahami dokumen kompleks.
Layanan OCR Berbasis Cloud
Layanan OCR berbasis API dari penyedia cloud besar (Google Cloud Vision, AWS Textract, Azure Computer Vision) memungkinkan pengembang mana pun yang memiliki kunci API mengakses OCR kelas perusahaan. Layanan ini terus berkembang seiring pemrosesan miliaran dokumen.
Pertanyaan Umum
Apakah OCR 100% akurat?
Akurasi pengenalan bergantung pada gambar sumber, bahasa, bentuk huruf, dan tata letak. Tidak ada persentase tetap yang dijanjikan di sini. Cocokkan sampel yang mewakili dokumen dengan sumber asli, terutama nama dan angka; skor keyakinan model bukan tingkat akurasi karakter yang telah diukur.
Apakah OCR dapat mengenali semua font?
Sebagian besar font standar (Times New Roman, Arial, Helvetica, dan sebagainya) memberikan hasil yang sangat baik. Font yang sangat dekoratif, bergaya tulisan sambung, atau tidak lazim mungkin memiliki tingkat pengenalan lebih rendah. Secara historis, OCR dioptimalkan untuk font yang umum digunakan dalam bisnis dan percetakan.
Apakah OCR dapat mengenali tulisan tangan?
Ya, dengan keterbatasan. Tulisan tangan bergaya cetak (huruf terpisah) memberikan hasil jauh lebih baik daripada tulisan sambung. OCR modern berbasis AI telah banyak meningkatkan pengenalan tulisan tangan, tetapi akurasinya sangat bervariasi menurut gaya tulisan setiap orang.
Apa perbedaan OCR dan ekstraksi teks dari PDF?
Ekstraksi teks PDF membaca teks digital yang tertanam dalam PDF yang dibuat secara digital (seperti dokumen Word yang disimpan sebagai PDF). Pengenalan tidak diperlukan karena data teksnya sudah tersedia. OCR diperlukan untuk dokumen hasil pindai, foto, dan PDF yang dibuat dengan memindai dokumen fisik, ketika teks hanya tersimpan sebagai piksel.
Apakah OCR dapat mengenali beberapa bahasa dalam satu dokumen?
Beberapa sistem OCR mendukung deteksi otomatis atau beberapa bahasa pengenalan sekaligus. Di sini, Anda memilih salah satu dari 15 bahasa secara manual; deteksi otomatis dan pilihan gabungan bahasa tidak tersedia. Periksa teks campuran bahasa dengan cermat, atau proses potongan area yang sesuai secara terpisah.
Bagaimana OCR menangani tabel dan data terstruktur?
Beberapa sistem pemrosesan dokumen merekonstruksi tabel. Alat ini menghasilkan teks biasa, sehingga kolom atau batas sel dapat hilang. Bandingkan urutan baca dan angka dengan sumber asli, lalu susun ulang tabel di editor yang sesuai jika diperlukan.
Ringkasan
OCR telah menjadi salah satu teknologi paling berpengaruh di era digital tanpa banyak disadari. Teknologi ini menghubungkan dunia fisik dan digital, sehingga begitu banyak informasi dalam bentuk cetak maupun tulisan dapat diakses, ditelusuri, dan diproses.
Dari digitalisasi dokumen hingga penerjemahan langsung, dari rekam medis hingga keamanan perbatasan, OCR hadir dalam lebih banyak aspek kehidupan sehari-hari daripada yang disadari kebanyakan orang.
Coba sendiri alat OCR gratis kami — unggah gambar yang berisi teks dan lihat cara kerja teknologi ini.
Alat terkait: Gambar ke Teks | PDF ke Gambar | Gambar ke PDF
Alat lain untuk kebutuhan gambar Anda berikutnya
Jelajahi alat ImgConvert untuk konversi, file PDF, dan GIF.
- Konverter gambar
- Alat PDF
- Alat GIF