OCR Nedir? Optik Karakter Tanıma Teknolojisi İçin Kapsamlı Rehber
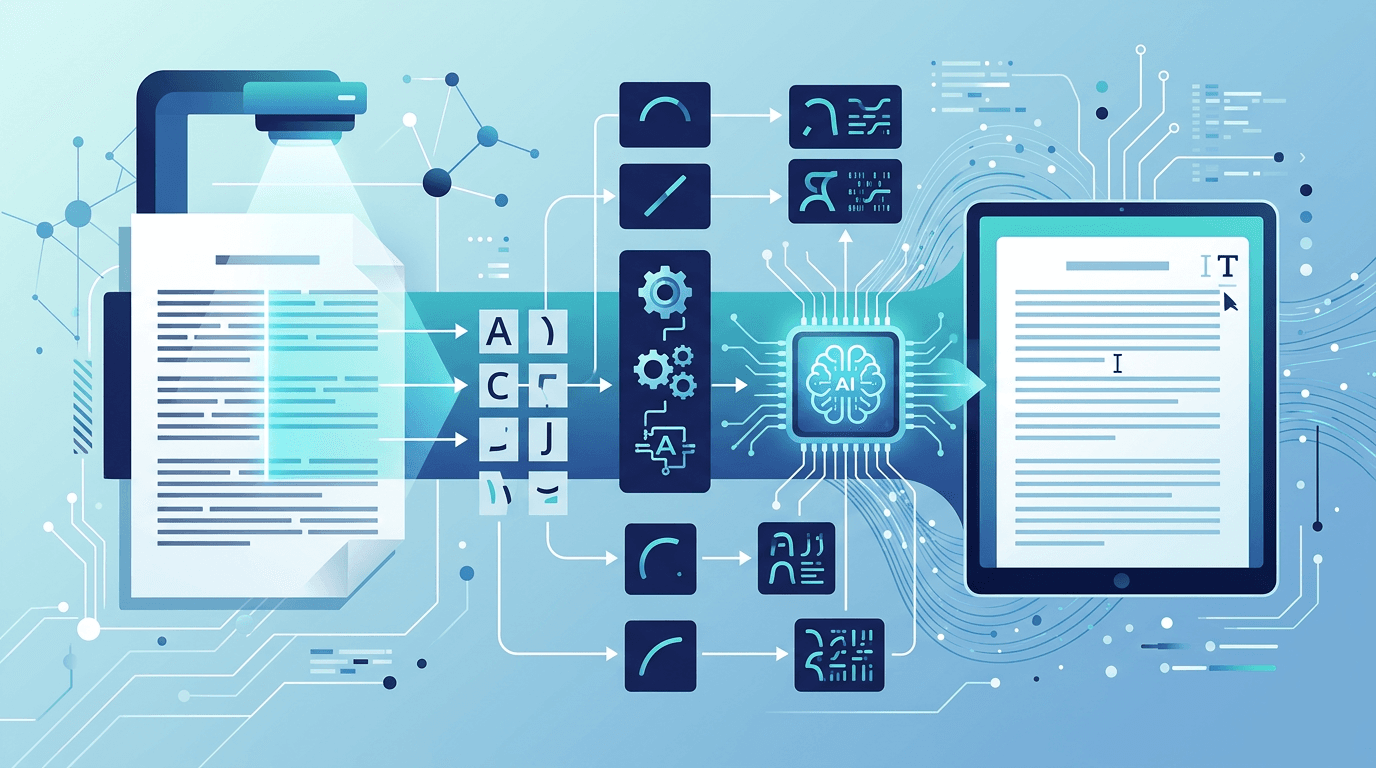
Bir fişin fotoğrafını çekip tutarların gider uygulamasına otomatik girilmesini sağladığınızda veya bir kartviziti fotoğraflayıp iletişim bilgilerini telefonunuza aktardığınızda OCR teknolojisini kullanmış olursunuz. Optik karakter tanıma, fark edilmeden vazgeçilmez hâle gelen teknolojilerden biridir; her yerde karşımıza çıkar ama çoğu kişi nasıl çalıştığını pek bilmez.
Bu rehber, OCR'nin tam olarak ne olduğunu, arkasındaki teknolojiyi, nerelerde kullanıldığını ve sınırlarını açıklar.
Aşağıdaki bölümler genel olarak OCR teknolojisini anlatır. Sayfa düzenini yeniden oluşturma, çeviri, otomatik dil algılama ve el yazısı modelleri gibi özellikler ürüne göre değişir. Bu sitenin Görselden Metne aracı, elle seçilen tek bir dili kullanarak tek bir görselden düz metin çıkarır; bu daha kapsamlı özellikleri sunmaz.
OCR nedir?
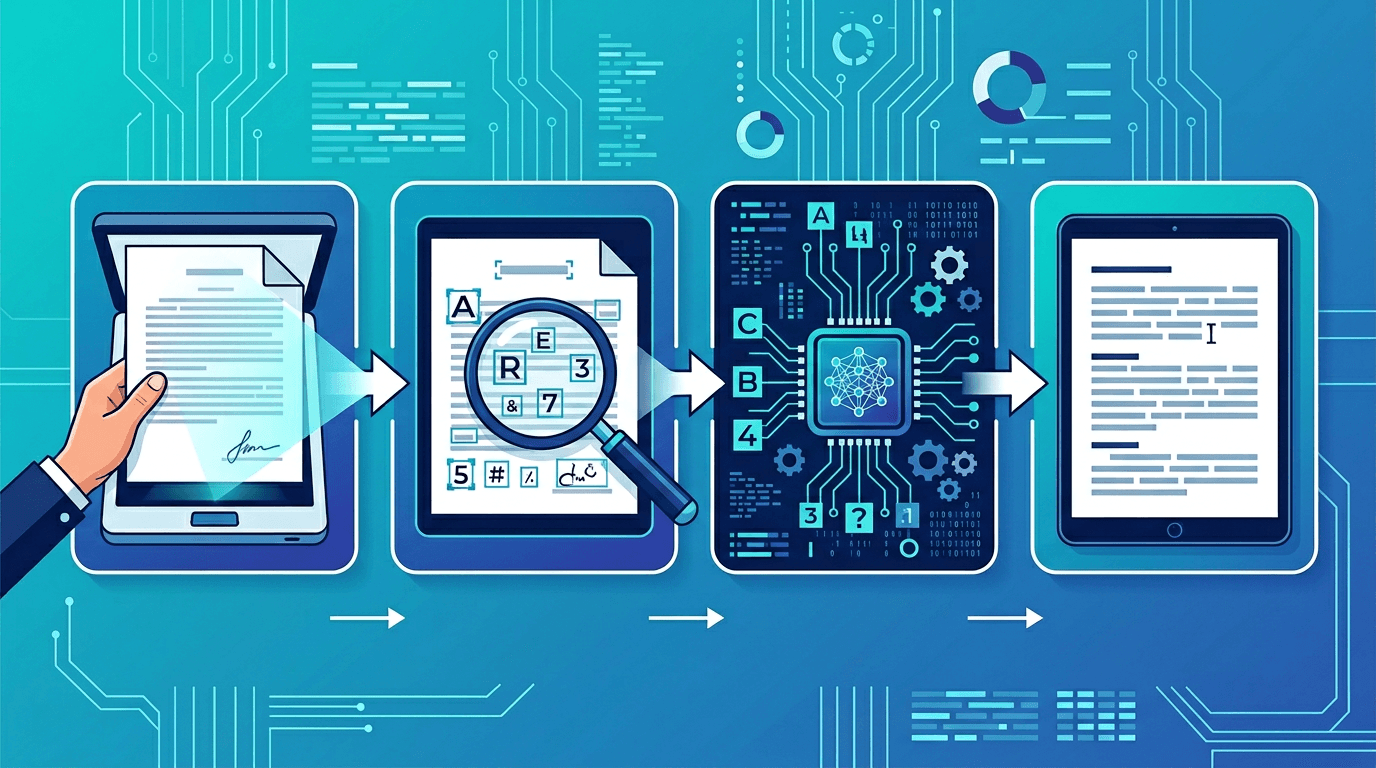
OCR, optik karakter tanıma anlamına gelen Optical Character Recognition ifadesinin kısaltmasıdır. Bilgisayarların görsellerdeki, taranmış belgelerdeki ve fotoğraflardaki metni tanıyıp çıkarmasını, görsel metni makinelerin okuyabileceği dijital metne dönüştürmesini sağlayan bir teknolojidir.
Temelde OCR dört iş yapar:
- Metni tanır — görsellerde, taranmış belgelerde ve fotoğraflarda
- Görsel metni dönüştürür — dijital, düzenlenebilir ve aranabilir biçime
- Arama yapılmasını sağlar — daha önce içinde arama yapılamayan görsel tabanlı içeriklerde
- Veri girişini otomatikleştirir — fiziksel belgelerden bilgi çıkararak
OCR'den önce bir belgenin fotoğrafı yalnızca bir fotoğraftı; içindeki metin bilgisayar açısından yok sayılırdı. OCR, basılı metnin fiziksel dünyası ile aranabilir ve işlenebilir verinin dijital dünyası arasında köprü kurar.
OCR teknolojisi nasıl çalışır?
Modern OCR, birbiri ardına yürütülen gelişmiş işlemlerden oluşur. Bu aşamaları anlamak, OCR'nin iyi koşullarda neden bu kadar doğru çalıştığını ve zor koşullarda neden zorlandığını açıklar.
Aşama 1: Görseli alma
Süreç, görselin yakalanması veya içe aktarılmasıyla başlar:
- Fiziksel bir belgeyi düz yataklı tarayıcı veya belge tarayıcıyla tarama
- Metni akıllı telefon kamerasıyla fotoğraflama
- Ekrandaki içeriğin ekran görüntüsünü alma
- Mevcut bir görsel dosyasını içe aktarma (JPG, PNG, PDF, TIFF vb.)
Bu aşamadaki kalite belirleyicidir; sonraki tüm işlemlerin ulaşabileceği en iyi sonucu sınırlar. Bulanık veya kötü aydınlatılmış bir fotoğraf, net ve yüksek çözünürlüklü bir taramadan daha zayıf sonuç verir.
Aşama 2: Görseli ön işleme
Karakter tanıma başlamadan önce görsele çeşitli iyileştirme işlemleri uygulanır:
- İkilileştirme: Görseli yalnızca siyah ve beyazdan oluşacak biçime dönüştürür. Renk bilgisini kaldırıp görseli sadeleştirerek metni arka plandan ayırmayı kolaylaştırır.
- Gürültü azaltma: Karakter sanılabilecek lekeleri, grenleri ve görüntü bozulmalarını kaldırır.
- Eğim düzeltme: Eğik veya döndürülmüş belgeleri düzeltir. Bir sayfayı hafif açılı fotoğrafladıysanız bu adım onu düzleştirir.
- Nokta temizleme: Görseldeki küçük, rastgele noktaları kaldırır.
- Sayfa düzeni analizi: Ana metin, başlıklar, yan sütunlar, tablolar ve görseller gibi farklı bölgeleri belirleyip ayırır; böylece her bölge uygun şekilde işlenebilir.
Aşama 3: Karakter tanıma
Metnin asıl tanındığı aşama budur. Modern OCR motorları birden fazla yaklaşımı aynı anda kullanır:
Örüntü eşleştirme: Tek tek karakterleri bilinen karakter şekillerinden oluşan bir kütüphaneyle karşılaştırır. Standart, belirgin yazı tiplerinde etkilidir.
Özellik algılama: Her karakterin kendine özgü yapısal özelliklerini, yani eğrilerini, kesişimlerini ve kapalı alanlarını analiz eder. Örneğin "B" harfinin sağ tarafında iki kapalı alan, "P" harfinde ise bir kapalı alan vardır. Bu yapısal özellikler, şekiller tam olarak aynı olmasa bile karakterlerin tanınmasını sağlar.
Sinir ağları: Modern OCR motorları, milyonlarca metin örneğiyle eğitilmiş derin öğrenme modelleri kullanır. Bu modeller çok çeşitli yazı tiplerinde, boyutlarda, el yazısı stillerinde ve görsel koşullarında karakter tanımayı öğrenmiştir.
Bağlam analizi: Tek tek karakterler belirlendikten sonra dilsel analiz sonuçları iyileştirir. Karakter algılama "house" yerine "h0use" sonucunu verdiyse dil modeli, çevredeki kelimelere ve dil örüntülerine dayanarak bu bağlamdaki "0" karakterinin büyük olasılıkla "o" olduğunu anlar.
Aşama 4: Son işleme
Son aşamada çıktı iyileştirilir ve kullanıma hazırlanır:
- Yazım denetimi: Sözlükten kontrol ederek belirgin hataları işaretler ve düzeltir
- Sayfa düzenini koruma: Özgün belgenin yapısal biçimini korur (sütunlar, tablolar, paragraf sonları)
- Güven puanlaması: Tanınan her karaktere veya kelimeye bir güven yüzdesi atar; böylece uygulamalar düşük güvenli sonuçları insan incelemesi için işaretleyebilir
- Çıktı biçimlendirme: Sonuçları istenen biçimde dışa aktarır (düz metin, aranabilir PDF, Word belgesi, yapılandırılmış veri)
OCR teknolojisi türleri
Standart OCR
İlk ortaya çıkan ve en yaygın türdür:
- Standart yazı tipleriyle basılmış metni tanır
- Temiz, yüksek kaliteli görsellerde ve iyi aydınlatma koşullarında en iyi sonucu verir
- Resmî belgelerin işlenmesinde en yüksek doğruluğa ulaşır
- Basılı materyallerin büyük çoğunluğuyla çalışır
Akıllı karakter tanıma (ICR)
Özellikle el yazısı için geliştirilmiş bir yaklaşımdır:
- Farklı el yazısı stillerini işlemek için gelişmiş makine öğrenmesi kullanır
- Daha fazla örnek gördükçe sürekli gelişir
- Basılı metinlerde standart OCR'den hâlâ daha düşük doğruluğa sahiptir
- Banka çeklerinin işlenmesinde, tarihî belgelerin dijitalleştirilmesinde ve form işlemede kullanılır
Akıllı kelime tanıma (IWR)
Tek tek karakterler yerine kelimelerin tamamını tanıyarak bütüncül bir yaklaşım benimser:
- Karakterlerin birbirine bağlandığı bitişik el yazısında daha etkilidir
- Bağlamı dikkate alan işleme doğruluğu artırır
- Doğal metinler için dil modelleriyle birleştirilir
- Posta ayrıştırmada ve formların dijitalleştirilmesinde kullanılır
Optik işaret tanıma (OMR)
Metin okumak yerine işaretleri algılamak için özelleştirilmiş bir türdür:
- Onay kutularını, cevap dairelerini ve işaretleri belirler (dolu veya boş)
- Standart sınavlarda, anketlerde ve oy pusulası taramada kullanılır
- İkili algılama yapar: işaretli veya işaretsiz
- Görsel kalitesi iyi olduğunda doğruluğu çok yüksektir
Barkod ve QR kod tanıma
Teknik olarak metin OCR'sinden ayrı olan bu ilişkili teknolojiler:
- 1D ve 2D barkodları okur
- QR kodlarını çözer
- Görsel metin yerine kodlanmış veriyi çıkarır
- OCR özelliği olan birçok uygulamaya entegre edilir
OCR doğruluğunu etkileyen faktörler
OCR'nin iyi veya kötü çalışmasına nelerin yol açtığını anlamak, daha iyi sonuçlar almanıza yardımcı olur:
| Faktör | Doğruluğa etkisi | Notlar |
|---|---|---|
| Görsel çözünürlüğü | Yüksek | Her karakteri ayırt edecek kadar piksel gerekir; tek başına DPI etiketi yeterli değildir |
| Görsel netliği | Çok yüksek | Bulanıklık kaliteyi en çok düşüren etkendir |
| Metin kontrastı | Yüksek | Açık arka plan üzerinde koyu metin idealdir |
| Yazı tipi | Orta-yüksek | Standart yazı tipleri > dekoratif yazı tipleri |
| Belgenin durumu | Orta | Kırışıklıklar, lekeler ve hasar doğruluğu azaltır |
| Dilin karmaşıklığı | Orta | Latin yazı sistemleri, karmaşık yazı sistemlerinden daha kolaydır |
| El yazısı | Yüksek | Kişisel farklılıklar tanımayı zorlaştırır |
| Aydınlatma | Yüksek | Dengesiz aydınlatma gölgeler ve görüntü bozulmaları oluşturur |
OCR'nin gerçek hayattaki kullanım alanları
OCR tek bir kullanım senaryosundan ibaret değildir; birçok sektörde onlarca uygulamayı mümkün kılan temel bir teknolojidir:
Belgeleri dijitalleştirme
Kütüphaneler, hukuk büroları, kamu kurumları ve işletmeler, onlarca yıllık kâğıt kayıtları aranabilir dijital arşivlere dönüştürmek için OCR kullanır. Önceden dosya dolaplarında elle aranması gereken bir belge, tam metin aramasıyla saniyeler içinde bulunabilir.
Otomatik veri girişi
OCR; faturalardaki, satın alma siparişlerindeki veya formlardaki verilerin veri tabanlarına elle yazılması yerine bilgiyi otomatik olarak çıkarır. Bu yöntem borç hesaplarının takibinde, sigorta taleplerinin işlenmesinde ve sağlık kayıtlarının yönetiminde yaygın olarak kullanılır.
Erişilebilirlik
OCR, yardımcı teknolojiler için okunabilir metin sağlayabilir. Erişilebilir bir PDF için doğru okuma sırası ve belge yapısı da gerekir; W3C'nin OCR tekniği bu kontrolleri içerir. Bu site, etiketli PDF yerine düz metin dışa aktarır.
Çeviri hizmetleri
Çeviri uygulamaları, çeviriden önce görsellerden metin çıkarmak için OCR kullanır. Kameranızı yabancı dilde bir menüye yönelttiğinizde OCR, anında çevrilebilmesi için metni yakalar.
Hukuki belge incelemesi
Dava süreçlerinde hukuk ekiplerinin binlerce belgeyi araması gerekir. OCR, taranmış belgeleri aranabilir metne dönüştürerek tüm belge koleksiyonunda belirli terimleri veya ifadeleri aramayı mümkün kılar.
Finansal hizmetler
OCR, belge görsellerinden basılı hesap numaralarını veya tutarları çıkarmaya yardımcı olabilir. Karakterleri tanımak, imzayı doğrulamaz veya belgenin gerçekliğini kanıtlamaz; bu kontroller ayrı bir süreç gerektirir. Bu site yalnızca metin çıkarma sağlar.
Sağlık hizmetleri
Tıbbi kayıt yönetimi; el yazısı notları, laboratuvar raporlarını ve reçeteleri yapılandırılmış elektronik kayıtlara dönüştürmek için giderek daha fazla OCR'ye dayanır. Bu, kayıt tutma doğruluğunu artırır ve daha iyi veri analizi sağlar.
Sınır kontrolü ve güvenlik
Pasaportlar, kimlik belgeleri ve vizeler, OCR sistemlerinin sınır geçişlerinde otomatik okuduğu makine tarafından okunabilir alanlar (MRZ) kullanır. Bu, işlemleri hızlandırır ve doğrulama doğruluğunu artırır.
OCR teknolojisini kendiniz deneyin
Görselden Metne aracını tek bir JPG/JPEG, PNG, WebP, GIF, BMP veya TIFF ile kullanın. Göndermeden önce 15 metin tanıma dilinden birini seçin; başlangıçta İngilizce seçilidir. Tanıma işlemi sunucuda gerçekleşir. Sonucu görselle karşılaştırın, ardından düz metni kopyalayın veya indirin. Araç çeviri yapmaz ve belge düzenini yeniden oluşturmaz.
Burada PDF girdisi kabul edilmez. Önce PDF'den Görsele aracını kullanın ve gerekli sayfa görsellerindeki metinleri tek tek tanıtın. Görsel sınırları 20 MB, kenar başına 8192 px ve 25 milyon pikseldir. Bunların tümü birlikte geçerlidir.
OCR ile elle veri girişinin karşılaştırması
OCR, belge içeriğini bir kişinin elle yazmasıyla karşılaştırıldığında nasıl bir performans gösterir?
| Özellik | OCR | Elle veri girişi |
|---|---|---|
| Hız | Sayfa başına saniyeler | Sayfa başına dakikalar veya saatler |
| Maliyet | Ücretsiz ile düşük maliyet arası | Sayfa veya saat başına işçilik maliyeti |
| Doğruluk | Görsele ve tanıma modeline bağlıdır | İşe ve metnin kontrol edilmesine bağlıdır |
| Kapasite | Dosyalar, işlem kaynakları ve istek sınırlarıyla sınırlıdır | Kullanılabilir zaman ve personelle sınırlıdır |
| Tutarlılık | Yüksek | Değişken (yorgunluk, dikkat dağınıklığı) |
| Kullanılabilirlik | 24/7 | Çalışma saatleri |
Yüksek hacimli belge işlemede OCR, hız ve maliyet açısından belirgin biçimde avantajlıdır. Yalnızca yazıya aktarma yerine yorumlama gerektiren az sayıdaki çok karmaşık belgede ise insan incelemesi değerini korur.
OCR'nin sınırları ve zorlukları
Önemli ilerlemelere rağmen OCR kusursuz değildir. Sınırlarını bilmek, beklentilerinizi doğru belirlemenize yardımcı olur:
Görsel kalitesine bağımlılık
Görsel kalitesi düştüğünde OCR doğruluğu ciddi biçimde azalır. Düşük çözünürlüklü görseller, bulanık fotoğraflar, kötü aydınlatma ve yoğun sıkıştırma sonuçları etkiler. Burada "kötü girdiden iyi çıktı çıkmaz" ilkesi özellikle geçerlidir.
El yazısındaki çeşitlilik
Modern OCR birçok el yazısı stilini işleyebilse de kişisel farklılıklar zorluk yaratmaya devam eder. Alışılmadık harf biçimleri, tutarsız boşluklar ve çok stilize yazılar tanıma algoritmalarını yanıltabilir.
Karmaşık sayfa düzenlerini işleme
Çok sütunlu düzenler, tablolar, dipnotlar ve farklı içerik türlerini bir araya getiren belgeler gelişmiş sayfa düzeni analizi gerektirir. Metin görsellerin etrafına sarıldığında veya sütunlar açıkça ayrılmadığında OCR zorlanabilir.
Dil ve yazı sistemi desteği
Latin alfabesini kullanan yaygın diller genellikle çok iyi OCR desteğine sahiptir. Daha az yaygın diller, sağdan sola yazılan yazı sistemleri (Arapça, İbranice) ve karmaşık karakter kümeleri (Çince, Japonca, Korece) geçmişte özel OCR motorları gerektiriyordu; modern yapay zekâ tabanlı sistemler ise bu farkı önemli ölçüde azalttı.
Matematiksel formüller ve özel semboller
Matematiksel gösterimler, kimyasal formüller veya alışılmadık sembol kümeleri içeren teknik belgeler, bu biçimler üzerinde özel olarak eğitilmemiş OCR sistemlerini zorlayabilir.
OCR teknolojisinin geleceği
Yapay zekâ ve derin öğrenme entegrasyonu
OCR için kullanılan sinir ağı modelleri her yıl daha yetenekli hâle geliyor. Modern sistemler, geleneksel örüntü eşleştirme yaklaşımlarıyla mümkün olmayacak doğruluk oranlarına ulaşıyor. Büyük dil modellerinin de temelinde bulunan transformer tabanlı mimarilere yönelim, OCR doğruluğunu daha da artırıyor.
Mobil cihazlarda gerçek zamanlı OCR
Modern akıllı telefonlar doğrudan kamera vizöründe gerçek zamanlı OCR yapabilir. Google Lens, Apple'ın Canlı Metin özelliği ve benzer özellikler, OCR'nin artık mobil cihazdaki canlı video akışında çalışacak kadar hızlı olduğunu gösterir.
Çok modlu belge anlama
Bir sonraki hedef yalnızca metni tanımak değil; tablolar, grafikler, metin ile görseller arasındaki ilişkiler dahil olmak üzere belgelerin tüm yapısını ve anlamını kavramaktır. Görsel anlama ile dil anlamayı birleştiren yapay zekâ sistemleri, karmaşık belgeleri anlamada insan düzeyine yaklaşıyor.
Bulut tabanlı OCR hizmetleri
Büyük bulut sağlayıcılarının API tabanlı OCR hizmetleri (Google Cloud Vision, AWS Textract, Azure Computer Vision), API anahtarı olan her geliştiricinin kurumsal düzeyde OCR'ye erişmesini sağlar. Bu hizmetler milyarlarca belgeyi işledikçe gelişmeye devam eder.
Sık sorulan sorular
OCR %100 doğru mu?
Tanıma doğruluğu kaynak görsele, dile, yazı biçimine ve sayfa düzenine bağlıdır. Burada sabit bir yüzde vaat edilmez. Temsil edici bir örneği, özellikle adları ve sayıları, özgün görselle karşılaştırın; modelin güven puanı, ölçülmüş bir karakter doğruluk oranı değildir.
OCR her yazı tipini tanıyabilir mi?
Çoğu standart yazı tipi (Times New Roman, Arial, Helvetica vb.) çok iyi sonuç verir. Çok dekoratif, el yazısını andıran veya alışılmadık yazı tiplerinde tanıma oranları daha düşük olabilir. OCR, tarihsel olarak yaygın iş ve baskı yazı tipleri için optimize edilmiştir.
OCR el yazısında çalışır mı?
Evet, ancak sınırlamaları vardır. Matbaa yazısına benzer, ayrı harflerle yazılan el yazısı, bitişik el yazısından çok daha iyi sonuç verir. Modern yapay zekâ tabanlı OCR, el yazısı tanımayı önemli ölçüde iyileştirmiştir; yine de doğruluk kişinin yazı stiline göre büyük ölçüde değişir.
OCR ile PDF'den metin çıkarma arasındaki fark nedir?
PDF'den metin çıkarma, dijital olarak oluşturulmuş PDF'lere gömülü dijital metni okur (PDF olarak kaydedilen bir Word belgesi gibi). Metin verisi zaten bulunduğu için tanıma gerekmez. Metnin yalnızca piksel olarak bulunduğu taranmış belgelerde, fotoğraflarda ve fiziksel belgeler taranarak oluşturulan PDF'lerde OCR gerekir.
OCR tek bir belgede birden fazla dili tanıyabilir mi?
Bazı OCR sistemleri otomatik algılamayı veya aynı anda birden fazla metin tanıma dilini destekler. Burada 15 dilden birini elle seçersiniz; otomatik algılama ve birden fazla dili birlikte seçme sunulmaz. Birden fazla dil içeren metni dikkatle kontrol edin veya uygun bölgeleri kırpıp ayrı ayrı işleyin.
OCR tabloları ve yapılandırılmış verileri nasıl işler?
Bazı belge işleme sistemleri tabloları yeniden oluşturur. Bu araç düz metin döndürür; dolayısıyla sütunlar veya hücre sınırları kaybolabilir. Okuma sırasını ve sayıları özgün belgeyle karşılaştırın; gerekirse tabloyu uygun bir düzenleyicide yeniden oluşturun.
Özet
OCR, fark edilmeden dijital çağın en etkili teknolojilerinden biri hâline geldi. Fiziksel ve dijital dünyalar arasında köprü kurarak basılı ve yazılı hâlde kaydedilmiş çok büyük miktarda bilgiyi erişilebilir, aranabilir ve işlenebilir kılar.
Belge dijitalleştirmeden gerçek zamanlı çeviriye, sağlık kayıtlarından sınır güvenliğine kadar OCR, günlük yaşamın çoğu kişinin fark ettiğinden daha fazla alanında yer alır.
Ücretsiz OCR aracımızla kendiniz deneyin; metin içeren bir görsel yükleyin ve teknolojinin nasıl çalıştığını görün.
İlgili araçlar: Görselden Metne | PDF'den Görsele | Görselden PDF'ye
Sonraki görsel işleminiz için daha fazla araç
Dönüştürme, PDF dosyaları ve GIF işlemleri için ImgConvert araçlarını keşfedin.
- Görsel dönüştürücüler
- PDF araçları
- GIF araçları